
Wie Alarmierung funktioniert
Nützliche Regeln sind direkt nach der Installation aktiv; es muss nichts nachjustiert werden. Den Unterschied im Alltag macht, was den Lärm niedrig hält: Abhängigkeitsunterdrückung, Gruppierung nach Host, Wartungsfenster und eine Baseline, die lernt, bevor sie spricht.
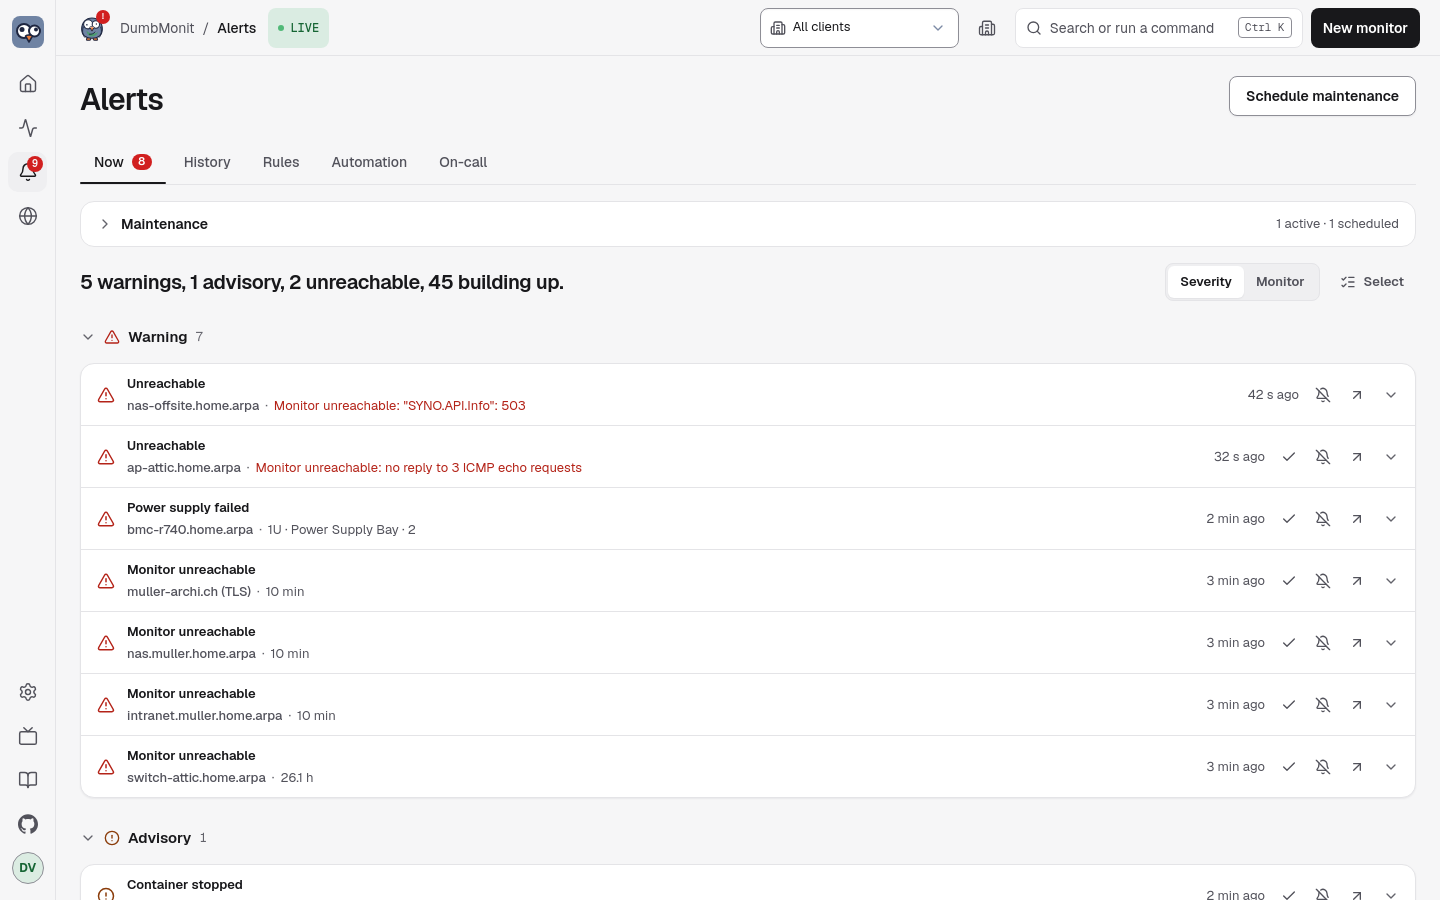
Schweregrade
Abschnitt betitelt „Schweregrade“Die Oberfläche spricht die Stufenleiter des Wetterberichts. Die API und der Regel-Editor speichern dieselben drei Stufen unter ihren Engine-Namen.
| In der UI | In der API (severity) | Bedeutung |
|---|---|---|
| Info | info | Gut zu wissen, keine Aktion erwartet. Wird von der Baseline-Regel genutzt. |
| Advisory | warning | Braucht bald Aufmerksamkeit: CPU hoch, Platte fast voll, langsamer Dienst. |
| Warning | critical | Braucht Sie jetzt: Monitor nicht erreichbar, Dienst ausgefallen, Backup-Prüfung fehlgeschlagen, Zertifikat abgelaufen. |
Eskalation hebt den Schweregrad einer Regel nach escalate_after um eine
Stufe an, wenn der Alarm weiter feuert (Info → Advisory → Warning; Warning
bleibt).
Jeder Alarm ist eine Zustandsmaschine, die alle 30 Sekunden ausgewertet wird
(DUMBMONIT_ALERT_INTERVAL_SECS).
| Phase | In der UI | Bedeutung |
|---|---|---|
ok | — | Die Bedingung ist falsch. |
pending | Baut sich auf | Die Bedingung ist wahr, aber die Haltezeit der Regel (for) ist noch nicht abgelaufen. Es wird nichts gesendet. |
firing | Feuert | Die Bedingung hat lange genug angehalten. Die erste Benachrichtigung geht raus, danach Erinnerungen alle repeat_interval (standardmäßig 6 Stunden für die meisten eingebauten Regeln), dann eine Eskalation, falls konfiguriert. |
resolved | Behoben | Zurück zum Normalzustand. Eine Behoben-Benachrichtigung wird nur gesendet, wenn das Feuern zuvor gemeldet wurde. |
suppressed | Durch übergeordneten Monitor unterdrückt | Der Alarm feuert, aber ein übergeordneter Monitor ist ausgefallen oder der Monitor selbst ist nicht erreichbar: siehe unten. |
phase ist der Zustand der Engine; effective_phase ist das, was Sie lesen.
Ein Alarm, dessen effective_phase gleich suppressed ist, behält darunter
phase = firing, sodass er bei der Wiederherstellung des übergeordneten
Monitors nicht erneut benachrichtigt wird.
Ein Alarm kann auch bestätigt werden (acked, mit acked_by,
acked_until und ack_note): Die Phase bewegt sich nicht, Erinnerungen und
Eskalationen pausieren bis acked_until, die Behoben-Meldung wird trotzdem
gesendet und löscht die Bestätigung. Das Stummschalten eines einzelnen
Alarms funktioniert im Hintergrund genauso, aber über ein Wartungsfenster, das
genau auf die Labels dieses Alarms begrenzt ist (silenced: true), statt auf
den ganzen Monitor: eine Schwesterregel auf demselben Monitor spricht weiter.
Siehe Einen Alarm loswerden.
Abhängigkeitsunterdrückung
Abschnitt betitelt „Abhängigkeitsunterdrückung“Jeder Monitor kann ein übergeordneter Monitor angeben. Wenn ein Monitor
ausgefallen ist, wird jeder Alarm auf seinen Nachkommen als Durch
übergeordneten Monitor unterdrückt markiert, statt gesendet zu werden: ein
ausfallender Switch erzeugt eine Benachrichtigung, nicht dreißig. Der
nächstgelegene ausgefallene Vorfahre wird als Ursache genannt
(suppressed_by), und die Kette wird bis zu 64 Ebenen verfolgt.
Ein Monitor gilt als ausgefallen, wenn einer dieser Alarme auf ihm feuert, gleich aus welchem Grund:
- Monitor unreachable: gar keine Messung (ein SNMP-Gerät, das nicht mehr antwortet, ein Agent, der nicht mehr pusht);
- Dienst ausgefallen: seine Verfügbarkeitsprüfung läuft, schlägt aber fehl (ein Ping mit 100 % Verlust, eine HTTP-Prüfung mit Fehler oder Zeitüberschreitung, ein geschlossener TCP-Port usw.).
Eine einfache Warnung auf dem übergeordneten Monitor (Festplatte voll, hohe CPU, langsamer Dienst, ein bald ablaufendes Zertifikat) verbirgt nichts: Das Gerät antwortet weiterhin, und alles dahinter ebenfalls. Der übergeordnete Monitor behält seinen eigenen Alarm und seine Benachrichtigung; sobald er sich erholt, feuern die Kinder, die noch ausgefallen sind, und benachrichtigen von selbst.
Dasselbe gilt für einen nicht erreichbaren Monitor selbst: Seine übrigen Alarme
(Festplatte voll, CPU usw.) werden durch seinen eigenen Ausfall unterdrückt,
wobei suppressed_by den Monitor selbst nennt, denn ihre Werte sind veraltet
und nur ein Symptom desselben Ausfalls. Nur sein Alarm „Monitor unreachable“
wird nie durch den eigenen Ausfall verborgen, sodass Sie einmal benachrichtigt
werden.
Der übergeordnete Monitor wird im Monitordialog gesetzt. Auf der Monitorseite stapeln sich Kinder unter ihrem Elternteil und werden abgedunkelt, wenn dieser ausgefallen ist.
Ein Relay-Agent zählt als übergeordneter Monitor jedes Monitors, den er abfragt (Erreicht über im Monitordialog), zusätzlich zu einem explizit gesetzten Elternteil: Ist das Relay ausgefallen, werden seine Monitore unterdrückt, wobei das Relay als Ursache genannt wird. Bei gleichem Abstand gewinnt der explizit gesetzte übergeordnete Monitor.
Ein übergeordneter Monitor gilt auch dann als ausgefallen, sobald seine eigene Abfrage das meldet (der Status Zeitüberschreitung, Monitor nicht erreichbar oder Dienst ausgefallen auf seiner Seite), ohne auf das Feuern seines eigenen Alarms zu warten: Ein Agent, der aufhört zu pushen, zieht seine Monitore ein bis zwei Minuten vor seinem eigenen Alarm mit sich, und ein Switch, dessen Ping gerade fehlgeschlagen ist, verbirgt seine Kinder, bevor die Wartezeit von „Dienst ausgefallen“ abgelaufen ist; diese würden sonst jeweils zuerst benachrichtigen.
Gruppierung, Deduplizierung, Erinnerungen
Abschnitt betitelt „Gruppierung, Deduplizierung, Erinnerungen“Ohne Gruppierung würde ein NAS mit degradiertem RAID eine Nachricht pro
Platte und pro Zyklus senden. DumbMonit sendet höchstens eine Nachricht pro
Host und pro Zyklus, auch wenn sie fünf Zeilen enthält. Jeder Alarm wird
einmal benachrichtigt, wenn er zu feuern beginnt (firing), danach nur noch
als Erinnerung (reminder, alle repeat_interval), als Eskalation
(escalation) oder als Behoben-Meldung (resolved). Die Alarmhistorie
protokolliert jeden Übergang mit der Information, ob benachrichtigt wurde
und, falls nicht, warum (Lernphase, unterdrückt, stummgeschaltet,
bestätigt).
Wartungsfenster
Abschnitt betitelt „Wartungsfenster“Eine Stummschaltung stoppt Benachrichtigungen, ohne die Auswertung zu stoppen: am Ende eines Fensters wird ein noch aktiver Alarm einmal benachrichtigt, statt nach zwei Stunden Existenz „geboren“ zu werden. Fenster sind einmalig oder wöchentlich, pro Monitor oder für die gesamte Instanz. Siehe Wartungsfenster.
Baseline-Lernen
Abschnitt betitelt „Baseline-Lernen“Die Regel „Unusual CPU“ braucht keinen Schwellenwert. Für jede Zeitreihe
hält sie 168 Buckets, einen pro (Wochentag, Stunde), und vergleicht jeden
Punkt mit dem, was zu diesem Zeitpunkt üblicherweise beobachtet wird. Der
Score ist robust (Median und MAD, ein EWMA pro Bucket mit alpha = 0.05),
sodass ein einzelner Vorfall die Baseline nicht neu schreibt und saisonale
Drifts berücksichtigt werden.
Die Regel bleibt während ihrer ersten vierzehn Lerntage still: Jeder Bucket muss mindestens zweimal beobachtet worden sein, um „unüblich“ von „nie beobachtet“ zu unterscheiden. In der Zwischenzeit wird sie mit einem Lernphase-Kennzeichen angezeigt und zeigt nur an, was sie ausgelöst hätte. Baselines von Zeitreihen, die verschwunden sind, werden nach 60 Tagen vergessen.
Vorhersagen
Abschnitt betitelt „Vorhersagen“Zwei Alarmarten sagen voraus statt zu melden, und die Übersicht listet sie
unter Vorhersagen: die Baseline-Anomalie und die predict-Regeln, die
eine Zeitreihe mit predict_linear() auf VictoriaMetrics-Seite
extrapolieren („Filesystem almost full“ innerhalb von vier Tagen). Die
PBS-Datastore-Schätzung ist ein einfacher Schwellenwert auf PBS’ eigener
Vorhersage.
Wohin Benachrichtigungen gehen
Abschnitt betitelt „Wohin Benachrichtigungen gehen“Eingebaute Regeln haben keinen zugewiesenen Kanal, was bedeutet jeder aktivierte Kanal. Eine selbst bearbeitete Regel kann bestimmte Kanäle benennen. Kanäle werden unter Settings → Notifications & reports konfiguriert; siehe Benachrichtigungskanäle.
Intelligente Benachrichtigungen
Abschnitt betitelt „Intelligente Benachrichtigungen“Alles oben entscheidet, ob ein Alarm sprechen darf. Eine zweite Stufe, die Benachrichtigungsrichtlinie, entscheidet wann und auf welchem Kanal, damit niemand zugespamt wird. Der vollständige Weg eines Alarms, in Reihenfolge:
- Auswerten — Schwellenwert, Anomalie-Score oder Vorhersage, mit der
Haltezeit der Regel (
for) und, falls gesetzt, ihrem Rückstellschwellenwert (Hysterese: feuert über 90 %, löst sich erst unter 85 %) und einer etwaigen monitorspezifischen Überschreibung. - Deduplizieren — ein Fingerprint pro (Regel, Zeitreihe), verankert an
der Monitor-ID (
target) statt an ihrem Namen: Das Umbenennen eines Monitors oder das Bearbeiten seiner Tags erzeugt keinen zweiten Alarm, und eine Zeitreihe, die zweimal auf denselben Schlüssel aufgelöst wird, ergibt einen Alarm. Zeitreihen eines gelöschten oder pausierten Monitors werden verworfen: ihre Alarme werden sofort gelöscht, ohne Benachrichtigung, und die Historie vermerktdevice removed or disabled. - Durch Abhängigkeit unterdrücken — Nachkommen eines ausgefallenen Monitors bleiben still.
- Stummschalten — Wartungsfenster dämpfen, was sie abdecken.
- Nach Monitor gruppieren — eine Nachricht pro Monitor und Zyklus, Erinnerungen und Eskalation eingefaltet.
- Flackersperre — ein Fingerprint, der innerhalb von 30 Minuten 4-mal feuert und sich löst, sendet eine einzige „Flattern“-Meldung, danach 30 Minuten lang nichts.
- Kanalspezifische Filter — Mindest-Schweregrad, „sag mir, wenn es sich löst“ an/aus, und ein Mindestabstand zwischen zwei Nachrichten zum selben Alarm.
- Ruhezeiten (pro Kanal) — nur Alarme der Stufe Warning kommen durch; der Rest wartet auf eine Zusammenfassung, wenn die Ruhezeit endet (ein Alarm, der sich währenddessen löst, wird nur als „während der Ruhezeit behoben“ erwähnt).
- Bündelung — Alarme innerhalb des Bündelungsfensters (standardmäßig 60 s) verlassen das System als eine Nachricht pro Kanal: „3 Alarme auf 2 Monitoren, 1 behoben“.
- Stündliches Limit — über
max_per_hourNachrichten auf einem Kanal hinaus warten Alarme und kommen als eine Zusammenfassung an („…und 7 weitere Alarme“). - Senden — mit einem „In DumbMonit öffnen“-Link pro Monitor, wenn eine öffentliche URL bekannt ist.
Die Schritte 6 bis 10 werden unter Settings → Notifications & reports → Notification policy (global) und bei jedem Kanal (Delivery options) konfiguriert. Siehe Benachrichtigungsrichtlinie.