
Proxmox VE
Hipervisor: nodos con sus demonios y redes, máquinas virtuales, contenedores, almacenamientos, pools LVM thin, copias de seguridad, alta disponibilidad, snapshots, replicación, Ceph hasta el OSD, discos físicos y pools ZFS, actualizaciones pendientes, cambios de paquete, suscripción y certificados. Un monitor puede cubrir todo un clúster.
El panel de nodos
Sección titulada «El panel de nodos»La página del monitor se abre con una tarjeta por nodo: CPU,
memoria y sistema de archivos raíz como tres medidores, el tiempo de
actividad y la versión pve-manager instalada en ese nodo, luego solo
lo que va mal — los demonios que no están en ejecución, las interfaces
declaradas al arrancar que no están activas — y el llenado de cada pool
thin LVM y grupo de volúmenes. Un nodo que dejó de responder conserva
su tarjeta y se lee offline.
Dos líneas bajo los medidores, cuando el nodo las reporta: la proporción de tiempo de CPU esperando al almacenamiento (I/O wait — un nodo al 10 % de CPU y 30 % de I/O wait no tiene ningún margen, y ningún otro número lo indica) y la memoria que KSM ha recuperado compartiendo páginas idénticas entre invitados, que es cómo un nodo alberga más de lo que tiene de RAM.
Dos entradas más se unen a la lista de «qué va mal», ambas en palabras:
- Reboot required — un kernel más nuevo está instalado que el que
se ejecuta. La tarjeta nombra ambas versiones, ya que el nodo sigue
ejecutando el antiguo hasta que se reinicia. Esto viene de
/nodes/{node}/apt/versions, que solo necesitaSys.Audit; - Updates pending — cuántos paquetes de Proxmox tienen una versión
candidata más reciente, de la misma llamada. No es lo mismo que
apt/update, que cuenta todos los paquetes pendientes del sistema pero necesitaSys.Modifyy normalmente se rechaza.
Cuando el clúster reporta un watchdog de HA (Proxmox VE 9 y posteriores), su estado se indica junto al título del panel: HA fencing armed una vez que se entregan recursos a HA, HA fencing standby mientras ninguno lo está — en cuyo caso ningún nodo será expulsado, lo cual es normal pero vale la pena saber antes de contar con ello.
Un clúster actualizado nodo por nodo lo muestra aquí: /version
responde por el nodo al que se le preguntó, así que cada tarjeta lleva
su propia versión y un rezagado es visible sin abrir una shell.
Los datos vienen de GET /api/targets/{id}/proxmox/nodes, leídos de
la última sonda en el almacén de métricas.
El panel de invitados
Sección titulada «El panel de invitados»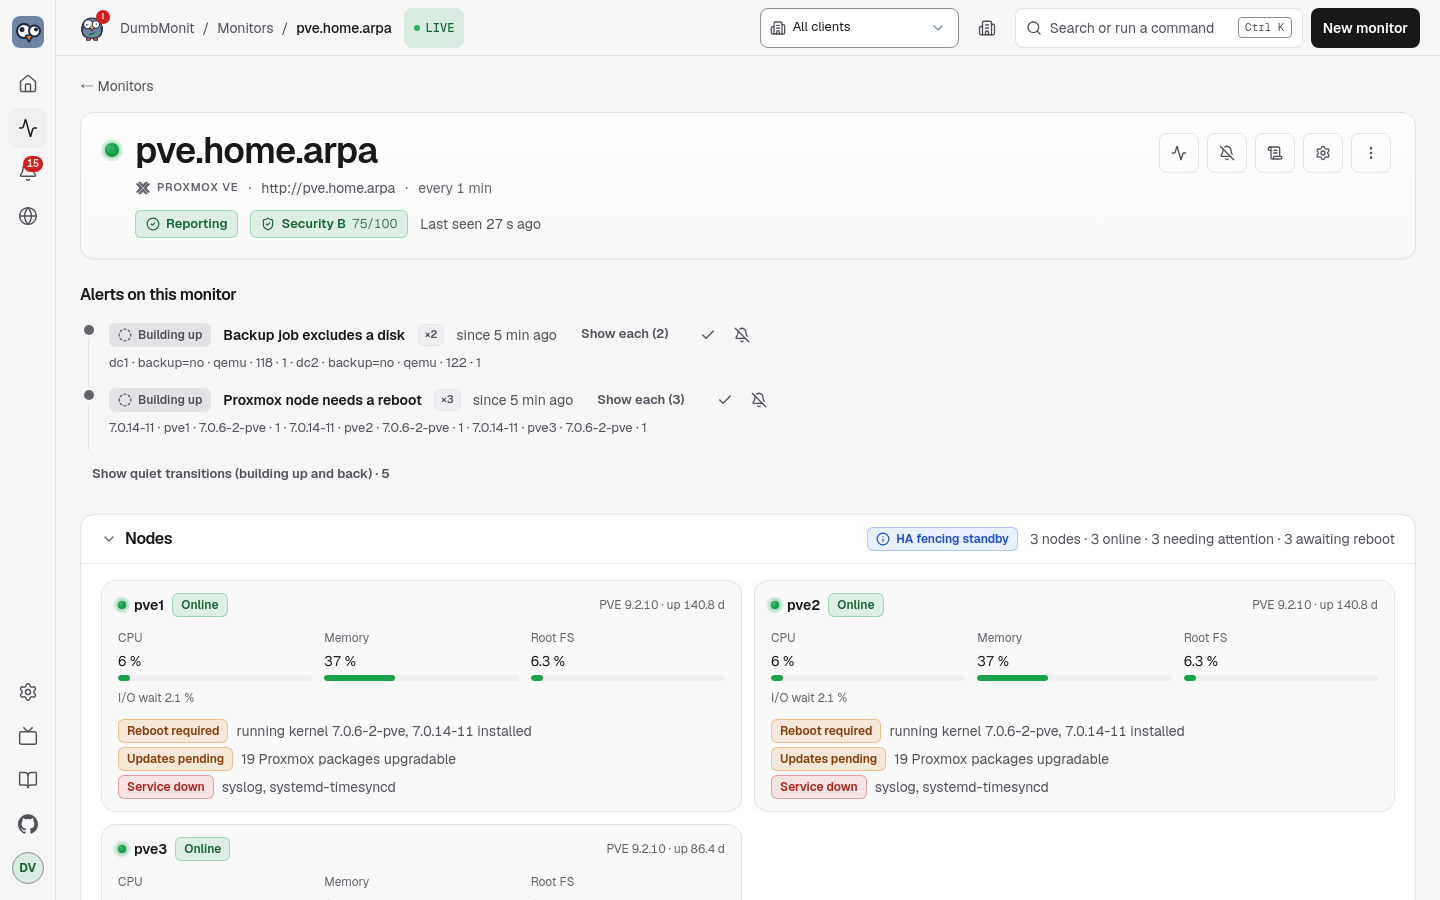
Bajo los nodos, el panel Guests: una fila por máquina virtual y contenedor, agrupados por nodo, que responde las preguntas que un administrador hace primero — ¿está en ejecución, está ocupado, su disco está lleno, cuándo se respaldó por última vez. Cada fila muestra:
| Columna | Fuente | Notas |
|---|---|---|
| Status | palabra + placa: running, stopped, paused, suspended, template | Una plantilla se lista pero nunca cuenta como «stopped». |
| Name, VMID, node | el inventario | |
| CPU | guest_cpu_percent, de los núcleos asignados al invitado | Una barra más el número de núcleos. |
| Memory | guest_memory_used_bytes / guest_memory_total_bytes | El tamaño del balloon cuando la VM tiene uno. Una segunda línea, +N on host, aparece cuando guest_memory_host_bytes está notablemente por encima de lo que ve el invitado: un proceso QEMU cuesta al hipervisor más que la memoria que entrega, y ese excedente es la sobrecarga de emulación. Por debajo de 64 MiB o 5 % la línea se oculta. |
| Disk | guest_disk_used_bytes / guest_disk_total_bytes | Contenedores: uso real. VMs: siempre el tamaño; el uso solo cuando responde el agente invitado QEMU (ver abajo), si no «size only». |
| Network | rate(guest_network_in/out_bytes) sobre las últimas sondas | |
| Uptime | guest_uptime_seconds | |
| Last backup | backup_last_age_seconds | Vacío cuando no se conoce ninguna copia. |
| HA | ha_resource_state_info | Solo para invitados bajo alta disponibilidad. |
| Lock | guest_locked | Una insignia, solo mientras se mantiene un bloqueo (backup, migrate, snapshot…). |
La lista ordena por cualquier columna, filtra por nodo, estado o pool,
y cada grupo de nodo se pliega. Hacer clic en una fila abre su CPU y
memoria sobre el rango de tiempo de la página, junto con el sistema
operativo y las direcciones IP vistas desde dentro del invitado. Los
datos vienen de GET /api/targets/{id}/proxmox/guests, que lee la
última sonda del almacén de métricas — nada se pide al hipervisor.
Un bloqueo es normal durante los pocos minutos que toma una copia de
seguridad, una migración o un snapshot. Dejado atrás por un trabajo
interrumpido, bloquea cada operación en ese invitado — incluida la
copia de seguridad de la noche siguiente — hasta que qm unlock (o
pct unlock) lo limpia, por lo que «Guest locked» se activa tras seis
horas.
El inventario viene de /cluster/resources, la propia caché del
clúster, así que los invitados de un nodo que dejó de responder siguen
listados — con el estado unknown y sus tamaños, sin mediciones en
vivo — en lugar de desaparecer del panel en el momento en que quieres
mirar. También cuesta dos llamadas de API menos por nodo que recorrer
/nodes/{node}/qemu y /nodes/{node}/lxc, que es a lo que recurre la
opción cluster_resources cuando está desactivada.
Uso de disco dentro de una VM: el agente invitado QEMU
Sección titulada «Uso de disco dentro de una VM: el agente invitado QEMU»Proxmox ve el disco de una VM como un volumen opaco: disk siempre es
0 para una VM, solo se conoce su tamaño. Para leer el uso desde
dentro, el recolector pide al agente invitado QEMU
(agent/get-fsinfo) para cada VM en ejecución cuya configuración
activa el agente (Options → QEMU Guest Agent). Dos condiciones:
qemu-guest-agentinstalado y en ejecución dentro de la VM (Debian y Ubuntu:apt install qemu-guest-agent; Windows: la ISO de controladores VirtIO);- el token tiene
VM.GuestAgent.Auditen la VM —VM.Monitorantes de Proxmox VE 9 (el rolDumbMonitde abajo lo concede en/).
El sistema de archivos raíz (/, o C:\ en Windows; si no, el más
grande) da guest_disk_used_bytes y guest_disk_used_percent, la
misma serie que tiene un contenedor, así que la regla «VM or container
disk almost full» cubre ambos. Cada sistema de archivos real también
obtiene guest_fs_total/used_bytes y guest_fs_used_percent con una
etiqueta mountpoint; los pseudo sistemas de archivos (tmpfs,
squashfs, montajes snap) y los medios sin capacidad se omiten.
guest_agent_enabled dice si la configuración de la VM activa el
agente, guest_agent_running si respondió. Sin el agente o el
derecho, la VM conserva su tamaño y simplemente no tiene uso — nunca
un «0 %» engañoso.
El sistema operativo y direcciones de un invitado
Sección titulada «El sistema operativo y direcciones de un invitado»Proxmox solo conoce el tipo de SO escrito en la configuración de un
invitado (l26, win11), no lo que realmente se ejecuta. Con la
opción guest_os activada, el recolector pregunta a cada invitado en
ejecución qué es: agent/get-osinfo y
agent/network-get-interfaces para una VM, /nodes/{node}/lxc/{vmid}/interfaces
para un contenedor, que no necesita nada instalado dentro. Eso da
guest_os_info (Debian GNU/Linux 12 (bookworm), su id, su versión,
el kernel) y hasta cuatro guest_ip_info — las direcciones loopback e
IPv6 link-local se omiten, y una máquina con decenas de interfaces
virtuales no llena la base de datos de series.
Ambas se piden como máximo una vez por hora por invitado y se republican de memoria entre medias: un sistema operativo no cambia entre dos sondas, y una dirección casi nunca lo hace. En un clúster de cincuenta máquinas en ejecución esa es la diferencia entre dos llamadas extra por sonda y dos por hora.
Esas dos llamadas de agente necesitan VM.GuestAgent.Audit. Proxmox
VE 7 no la tenía y usaba VM.Monitor; Proxmox VE 9 eliminó
VM.Monitor y conserva solo los privilegios de agente invitado. Sin
la que conoce tu versión, las dos series simplemente están ausentes;
nada más cambia.
El panel de Ceph
Sección titulada «El panel de Ceph»Una sección Ceph aparece en la página del monitor solo cuando el clúster realmente tiene Ceph: salud y las palabras detrás de ella, capacidad total y usada, cuántos OSD están up e in, una tabla de OSDs (host, clase de monitor, uso, latencia de apply y commit) y una tabla de pools (uso, size y min size, placement groups frente al número que elegiría el autoscaler), los sistemas de archivos CephFS, las flags de OSD dejadas activas y las comprobaciones de salud actualmente silenciadas.
Esas dos últimas son las que un dashboard normalmente oculta. noout
activado para un mantenimiento y nunca limpiado significa que Ceph no
volverá a rebalancear un OSD muerto, y una comprobación silenciada ya
no aparece en HEALTH_OK — en ambos casos el clúster parece sano
mientras su redundancia desaparece silenciosamente.
GET /api/targets/{id}/proxmox/ceph responde available: false
cuando el clúster no tiene Ceph, que es cómo la UI sabe que no debe
dibujar la sección en absoluto. El detalle cuesta tres llamadas en un
único nodo más dos de todo el clúster, sea cual sea el tamaño del
clúster, y necesita la opción ceph_detail además de ceph.
Qué vigila
Sección titulada «Qué vigila»Todas las métricas tienen el prefijo dumbmonit_proxmox_.
| Familia | Métricas | Etiquetas |
|---|---|---|
| Clúster | cluster_quorate, cluster_nodes, cluster_nodes_online, cluster_member_online; version_info (+ version, release, repoid) | cluster, node |
| Inventario de clúster | cluster_guests_total, cluster_guests_running, cluster_templates_total (plantillas contadas aparte, nunca como «stopped»); pool_guests, uno por pool de recursos | pool |
| Nodos | node_up, node_cpu_percent, node_cpu_count, node_load1/5/15, node_memory_used/total_bytes, node_memory_percent, node_swap_used/total_bytes, node_rootfs_used/total/avail_bytes, node_rootfs_percent, node_cpu_iowait_percent (tiempo esperando a los discos — un nodo al 10% de CPU y 30% de iowait no tiene margen), node_ksm_shared_bytes (memoria recuperada por deduplicación de páginas), node_uptime_seconds, node_version_info | node |
| Servicios de nodo | node_service_running, node_service_state_info (+ state), node_services_failed, node_core_services_down; node_pve_version_info (+ version, release) para el nodo que respondió | node, service |
| Red de nodo | node_interface_active, node_interface_exists, node_interface_autostart, node_interface_mtu, node_interface_offline; total node_interfaces_offline | node, iface, type (bridge, bond, vlan, eth…) |
| LVM, thin pools y montajes | node_lvm_vg_size/free_bytes, node_lvm_vg_used_percent, node_lvm_vg_physical_volumes (etiqueta vg); node_thinpool_size_bytes, node_thinpool_used_bytes, node_thinpool_used_percent, node_thinpool_metadata_size_bytes, node_thinpool_metadata_used_percent (etiquetas vg, pool); node_directory_mount_info (+ path, device, fstype), node_directory_mounts | node, vg, pool |
| Invitados (VMs y contenedores) | guest_status_info (+ status: running, stopped, paused, suspended, template), guest_running (no para plantillas), guest_cpu_percent (de los núcleos asignados), guest_cpu_count, guest_memory_used/total_bytes, guest_memory_host_bytes (Proxmox VE 9: la memoria que toma la VM en el host, sobrecarga de emulación incluida), guest_memory_percent (desde el punto de vista propio del invitado; en Proxmox VE 9 viene del driver balloon, y una VM sin uno tiene bytes pero no porcentaje en lugar de una cifra por encima de 100%), guest_disk_total_bytes, guest_disk_used_bytes y guest_disk_used_percent (contenedores; VMs solo a través del agente invitado), guest_disk_read/write_bytes, guest_network_in/out_bytes (contadores), guest_uptime_seconds; guest_pool_info (+ pool), guest_locked (+ lock; la serie existe solo mientras se mantiene el bloqueo, así que su duración se lee directamente de la gráfica) | node, vmid, name, type (qemu o lxc) |
| Detalle de VM (VMs en ejecución) | guest_agent_enabled, guest_agent_running, guest_balloon_bytes, guest_memory_guest_free_bytes (memoria libre vista desde dentro, driver balloon), guest_running_qemu_info (+ version: el QEMU con el que se inició la VM — tras una actualización del hipervisor se queda atrás hasta que la VM se detiene y se inicia de nuevo, lo que una migración en vivo no hace); por sistema de archivos guest_fs_total_bytes, guest_fs_used_bytes, guest_fs_used_percent | node, vmid, name, type; sistemas de archivos: + mountpoint, fstype |
| Sistema y direcciones del invitado | guest_os_info (+ os, os_id, os_version, kernel), guest_ip_info (+ iface, ip; cuatro direcciones enrutables por invitado como máximo). Refrescado una vez por hora | node, vmid, name, type |
| Tarjetas de red del invitado | guest_netdev_in_bytes, guest_netdev_out_bytes (contadores), un par por interfaz virtual donde guest_network_in/out_bytes solo da el total del invitado | node, vmid, dev (tap100i0, veth200i0) |
| Almacenamientos | storage_active, storage_enabled, storage_used/total/avail_bytes, storage_used_percent (la capacidad se publica solo cuando Proxmox reporta una: un almacenamiento inactivo, o un datastore PBS cuyo tamaño PVE no lee, no obtiene ninguna en lugar de cero bytes) | node, storage, type (dir, lvmthin, zfspool, nfs, pbs…), shared |
| Copias de seguridad (por invitado) | backup_present, backup_last_timestamp_seconds, backup_last_age_seconds, backup_last_size_bytes, backup_count; totales backup_guests_total, backup_guests_without_backup | vmid, name, node, type |
| Copias de seguridad (ejecuciones vzdump, por nodo) | backup_job_runs, backup_job_failures, backup_job_last_ok, backup_job_last_timestamp_seconds, backup_job_last_age_seconds, backup_job_last_duration_seconds | node |
| Jobs de copia (programados) | backup_job_enabled, backup_job_next_run_seconds, backup_job_last_ok, backup_job_last_run_age_seconds (los dos últimos solo cuando una tarea vzdump lleva el id del job, PVE 7.2+); totales backup_jobs_total, backup_guests_not_covered; backup_covered por invitado (0 para un invitado que ningún job cubre) | job, storage, schedule; backup_covered: vmid, name, node, type |
| Cobertura de job de copia | backup_job_guests, backup_job_volumes_included, backup_job_volumes_excluded; backup_job_guest_excluded_volumes (+ vmid, name, type, reason), publicado solo para una exclusión inesperada | job |
| HA | ha_quorum_ok, ha_fencing_armed (+ state: Proxmox VE 9 reporta si el watchdog está armed o en standby — en standby nada será expulsado), ha_master_active, ha_lrm_active (node), ha_resources_total; por recurso ha_resource_started, ha_resource_error (1 en estado error, fence o recovery), ha_resource_state_info (+ state) | sid, node, vmid, type |
| Gestor HA | ha_node_online, ha_node_status_info (+ status: online, fence, gone, maintenance), ha_master_info (el nodo que tiene el CRM master), ha_manager_age_seconds; por nodo ha_lrm_mode_info (+ mode, state), ha_lrm_age_seconds, ha_lrm_stale (1 cuando el LRM no ha escrito en más de dos minutos) | node |
| Snapshots | guest_snapshot_count, guest_snapshot_oldest_age_seconds, guest_snapshot_newest_age_seconds (antigüedades solo cuando count > 0); guest_snapshot_guests_skipped cuando se supera max_snapshot_guests | vmid, name, node, type |
| Replicación | replication_job_enabled, replication_job_error (mensaje de error o fail_count > 0), replication_job_fail_count, replication_job_last_sync_age_seconds, replication_job_next_sync_seconds, replication_job_duration_seconds; replication_jobs_total | job, vmid, node (origen), to_node |
| Ceph | ceph_health (0 OK, 1 WARN, 2 ERR, 3 desconocido), ceph_health_info (+ status), ceph_osds_total/up/in, ceph_bytes_total/used, ceph_used_percent, ceph_pgs_total, ceph_mons_total | |
| OSDs de Ceph | ceph_osd_up, ceph_osd_in, ceph_osd_used_percent, ceph_osd_used_bytes, ceph_osd_total_bytes, ceph_osd_apply_latency_ms, ceph_osd_commit_latency_ms, ceph_osd_reweight, ceph_osd_crush_weight; totales ceph_osds_down, ceph_osds_out | osd, ceph_host, device_class |
| Pools de Ceph y CephFS | ceph_pool_used_percent, ceph_pool_used_bytes, ceph_pool_size, ceph_pool_min_size, ceph_pool_pg_num, ceph_pool_pg_num_optimal (lo que elegiría el autoscaler), ceph_pool_info (+ type, crush_rule, autoscale), ceph_pools_total; ceph_fs_info (+ metadata_pool, data_pool), ceph_fs_total | pool; CephFS: name |
| Flags y silencios de Ceph | ceph_flag (1 mientras la flag está activa), ceph_flags_set; ceph_health_mute_info (+ sticky), ceph_health_mutes | flag; silencios: code |
| Discos físicos | node_disk_size_bytes, node_disk_smart_failed (1 cuando la salud SMART es FAILED; ausente cuando el disco reporta UNKNOWN), node_disk_health_info (+ health, used: LVM, ZFS, partitions…), node_disk_wearout_percent (SSD y NVMe: 0 nuevo, 100 fin de vida nominal), node_disk_temperature_celsius (de disks/smart: atributo ATA 194/190, o la línea de temperatura de un informe de texto — Temperature: para NVMe, Current Drive Temperature: para SAS) | node, disk (/dev/sda, /dev/nvme0n1), model, type (ssd, hdd, nvme) |
| Pools ZFS | node_zfs_pool_degraded (1 a menos que ONLINE), node_zfs_pool_health_info (+ health), node_zfs_pool_size/alloc/free_bytes, node_zfs_pool_used_percent, node_zfs_pool_fragmentation_percent | node, pool |
| Actualizaciones | node_updates_pending, node_updates_security_pending (paquetes cuyo origen, etiqueta de repositorio, suite, sección o URL de changelog nombra un archivo de seguridad, como el bookworm-security de Debian). Sin Sys.Modify esas dos no existen; node_pve_packages_upgradable entonces sigue contando los paquetes de Proxmox cuya versión candidata difiere de la instalada, y node_reboot_required (+ running, installed) dice que hay un kernel más nuevo instalado pero no arrancado todavía — ambas leídas de apt/versions, que solo necesita Sys.Audit | node |
| Cambios de paquete | node_packages_changed: 0 normalmente; durante una hora después de que una sonda ve cambiar la versión instalada de un paquete de Proxmox (apt/versions), el número de paquetes que cambiaron, con una etiqueta changes como pve-manager 8.2.4→8.2.7, proxmox-kernel-6.8 6.8.8-2→6.8.12-2 | node, changes |
| Suscripción y repositorios | node_subscription_active, node_subscription_info (+ status: active, notfound, expired…, level, next_due); node_repository_errors (archivos sources ilegibles), node_repository_warnings (los propios avisos de Proxmox: repositorio enterprise sin suscripción, repositorio de prueba), node_repository_enabled (+ repo: enterprise, no-subscription, test, ceph-*) | node |
| Certificados | node_certificate_expiry_days (negativo una vez caducado) | node, filename, subject |
| Flujo RRD (desactivado por defecto) | node_rrd_<metric>, guest_rrd_<metric>, storage_rrd_<metric> — cada medición que reciben los propios servidores de métricas de Proxmox, bajo su propio nombre (ver metrics_export abajo) | node; invitados: vmid, type; almacenamientos: node, storage |
| Recolección | up, scrape_errors, scrape_duration_seconds |
La antigüedad de copia por máquina responde al fallo más costoso de un
homelab: la copia que no se ha ejecutado en semanas, descubierta el
día de la restauración. Se calcula a partir del registro de tareas
vzdump (sobre backup_lookback_days) y, si scan_backup_storage
está activado, de los archivos encontrados en los almacenamientos de
copia.
Los jobs programados vienen de Datacenter → Backup: backup_covered
es 0 para cada invitado que el propio Proxmox lista como no cubierto
por ningún job, así que una máquina creada ayer aparece antes de su
primera copia perdida en lugar de después.
Un job que cubre un invitado no necesariamente escribe todos sus
discos. Un volumen marcado backup=0 se omite cada noche, el job
sigue reportando éxito, y nadie se entera hasta una restauración.
backup_job_guest_excluded_volumes nombra el job, el invitado y el
propio motivo de Proxmox para la exclusión — pero solo cuando la
exclusión es una sorpresa: una unidad de CD-ROM, una imagen cloudinit
o una entrada que no es un volumen en absoluto se excluye por diseño,
contada en backup_job_volumes_excluded y nunca reportada por
invitado. Sin esa distinción, cada máquina con una unidad virtual
generaría una alerta.
Los demonios de un nodo valen la pena vigilarse por un motivo:
pvestatd detenido no rompe nada visiblemente — la interfaz web sigue
mostrando los números del momento en que murió, y todo parece normal.
node_core_services_down solo cuenta pve-cluster, pvedaemon,
pveproxy, pvestatd, pve-firewall, corosync y watchdog-mux, y
solo los que el propio nodo declara como activados, así que un nodo
independiente sin corosync ni HA no cuenta nada faltante.
Una interfaz cuenta como fuera de línea cuando está configurada para arrancar al inicio y no está activa (o ya no existe en absoluto). Una levantada a demanda, sin autostart, nunca se reporta: su ausencia es normal. Un bridge que no vuelve tras un reinicio corta cada invitado conectado a él mientras cada uno de esos invitados funciona perfectamente, y nada más lo indica.
Un pool thin LVM que se llena pone de golpe en solo lectura cada invitado almacenado en él, y eliminar archivos dentro de los invitados no devuelve el espacio. Sus metadatos viven en su propio volumen, mucho más pequeño, y a menudo se saturan primero, con exactamente la misma consecuencia — por lo que los dos niveles de llenado son series separadas y reglas separadas.
Los cambios de paquete los detecta el propio recolector: recuerda las versiones instaladas de la sonda anterior (por monitor y nodo, en memoria — un reinicio del servidor vuelve a aprender sin reportar). Solo un paquete presente en ambas sondas con una versión distinta cuenta; un paquete recién instalado o eliminado no.
Un fallo parcial (un nodo caído, un almacenamiento lento) sigue siendo
una sonda exitosa: lo que se pudo leer se escribe y el fallo se cuenta
en scrape_errors. Las funciones que simplemente están ausentes se
mantienen en silencio: sin Ceph, sin job de replicación, sin pool ZFS,
sin agente invitado, o sin derecho a listar actualizaciones no
producen ninguna serie ni ningún error. Lo mismo vale para todo lo de
arriba: un privilegio faltante (403), un endpoint que un Proxmox más
antiguo no tiene (404 o 501), una función no instalada (Ceph responde
500) no producen ningún error ni ninguna métrica en absoluto — nunca
un cero fingiendo ser una medición.
Las temperaturas de placa no están disponibles: la API de Proxmox VE no expone sensores, solo la temperatura SMART propia de los discos. Instala el agente de DumbMonit en el nodo si necesitas más.
Las reglas integradas que se aplican: Monitor unreachable, High CPU, Disk almost full, Filesystem almost full (forecast), Backup too old, Unusual CPU, VM or container stopped, VM or container CPU high, VM or container memory high, VM or container disk almost full, HA resource in error, Cluster lost quorum, Node offline, Storage almost full, Backup job failed, Old snapshot, Replication failed, Ceph health error, Ceph health warning, Updates pending, Security updates pending, Proxmox packages changed, Proxmox disk wearing out, Proxmox disk SMART failure, Proxmox ZFS pool degraded, Node certificate expiring, Thin pool almost full, Thin pool metadata almost full, Proxmox service down, Node network interface down, Ceph OSD down, Ceph OSD nearly full, Ceph pool almost full, Ceph noout flag left on, HA manager not reporting, Backup job excludes a disk, Guest locked.
El flujo RRD completo
Sección titulada «El flujo RRD completo»/cluster/metrics/export es el endpoint que consumen los propios
servidores de métricas de Proxmox (InfluxDB, Graphite): todo lo que
mide pvestatd, para todo el clúster, en una llamada. Dos cosas lo
hacen valioso.
- Lleva mediciones que nada más expone — en particular la información de presión por nodo (PSI): cuánto tiempo pasan las tareas esperando a la CPU, el disco o la memoria. Ese es el número que explica «todo está lento» cuando la CPU y la memoria se ven bien.
- Se lee con
history=1desde el último punto ya visto, así que cada punto entre dos sondas se ingiere con su propio timestamp. Un monitor sondeado cada cinco minutos obtiene sus cinco puntos de un minuto en lugar de un único valor actual.
Está desactivado por defecto, y eso es una decisión deliberada.
Esas series en parte repiten otras que ya produce el resto de la
recolección bajo mejores nombres, así que activar metrics_export
añade un gran número de series que guardar y examinar para un detalle
que la mayoría de instalaciones nunca mira. Los nombres se publican
exactamente como los envía Proxmox (node_rrd_pressure_cpu_some_avg10,
guest_rrd_netin…) en lugar de traducirse: Proxmox añade nuevos en
cada versión, y una tabla de traducción escrita aquí estaría
equivocada en la siguiente. Necesita Sys.Audit en / — que el rol
DumbMonit ya tiene cuando se concedió en / como abajo.
Qué preparar en Proxmox
Sección titulada «Qué preparar en Proxmox»Los pasos de abajo son los que muestra el aviso junto al formulario. El principio: un usuario reservado para monitorización, un rol que solo puede leer, un token — nunca la cuenta con la que inicias sesión.
-
Abre una shell en cualquier nodo (en la interfaz web: selecciona el nodo, luego Shell; o SSH) y crea un usuario reservado para monitorización. No necesita contraseña: el token es lo que inicia sesión.
pveum user add dumbmonit@pve --comment "DumbMonit monitoring" -
Crea un rol con solo los privilegios que usa el recolector: Sys.Audit (nodos, clúster, HA, discos y SMART, ZFS, certificados, versiones de paquete, suscripción), Datastore.Audit (almacenamientos y archivos de copia), VM.Audit (VMs, contenedores, snapshots) y VM.GuestAgent.Audit (lo que lee el agente invitado QEMU dentro de una VM: uso de disco, sistema operativo, direcciones IP). Ninguno de ellos puede cambiar nada.
pveum role add DumbMonit --privs "Datastore.Audit Sys.Audit VM.Audit VM.GuestAgent.Audit" -
Dale al usuario ese rol en todo el clúster.
pveum aclmod / -user dumbmonit@pve -role DumbMonit -
Crea el token de API del usuario. La separación de privilegios está desactivada, así que el token simplemente hereda los derechos del usuario.
pveum user token add dumbmonit@pve monitor --privsep 0 -
El comando imprime una tabla con full-tokenid y value. Copia full-tokenid en el campo Token ID de DumbMonit y value (el UUID) en su campo Secret. El secreto se muestra una vez: si se pierde, elimina el token y crea uno nuevo.
dumbmonit@pve!monitor -
Opcional, para contar actualizaciones pendientes y correcciones de seguridad pendientes: Proxmox protege esa lista con Sys.Modify. Concédelo solo en /nodes; sin él el recolector omite la lista en silencio.
pveum role add DumbMonitUpdates --privs Sys.Modifypveum aclmod /nodes -user dumbmonit@pve -role DumbMonitUpdates -
En un Proxmox más antiguo, VM.GuestAgent.Audit puede no existir todavía y el comando de arriba se rechaza con invalid privilege: las llamadas de agente invitado entonces están cubiertas por VM.Monitor, que Proxmox VE 9 a su vez eliminó. Usa el que conozca tu versión.
pveum role add DumbMonit --privs "Datastore.Audit Sys.Audit VM.Audit VM.Monitor" -
¿Prefieres la interfaz web? Los mismos pasos viven bajo Datacenter → Permissions: Users, Roles, Add → User Permission, y luego API Tokens con «Privilege Separation» desmarcado.
-
En DumbMonit, introduce la dirección de cualquier nodo (puerto 8006 por defecto).
Documentación del fabricante: Proxmox VE user management.
Credenciales
Sección titulada «Credenciales»| Credencial | Campos |
|---|---|
| Token de API (recomendado) | Token ID: usuario, reino y nombre de token tal como los muestra Proxmox, dumbmonit@pve!monitor. Secret: el UUID mostrado una vez al crear el token. Sin caducidad, sin sesión abierta en el hipervisor. |
| Nombre de usuario / contraseña | user@realm y la contraseña. Se obtiene un ticket, se cachea y se renueva diez minutos antes de su caducidad de dos horas. |
La API acepta el token en dos piezas (token_id + secret) o, como
hacían las versiones antiguas, como una cadena token =
user@realm!name=secret; ambas se guardan de la misma forma. Un token
completo pegado en Token ID se divide por el formulario.
El rol DumbMonit de arriba lleva lo que concede PVEAuditor para
las rutas que lee el recolector, más el privilegio de agente invitado:
el recolector solo hace GET. Por endpoint: Sys.Audit para
/version, /cluster/*, /nodes/{node}/status, services,
version, network, netstat, tasks, replication,
certificates/info, disks/list, disks/smart, disks/zfs,
apt/versions, apt/repositories y subscription; Datastore.Audit
para storage y storage/{id}/content; VM.Audit para qemu,
lxc, snapshot, status/current y las interfaces de un
contenedor; VM.GuestAgent.Audit — o VM.Monitor antes de Proxmox VE
9 — para agent/get-fsinfo.
Dos rutas piden un poco más que el resto, y ambas están cubiertas por
el rol tal como se concedió en el paso 3 — en /, no en /nodes:
Sys.Auditen/para el inventario LVM (disks/lvm,disks/lvmthin,disks/directory) y para/cluster/metrics/export, el flujo RRD opcional. Concedido solo en/nodes, las series de thin pool y las series*_rrd_*están ausentes en silencio.VM.GuestAgent.Auditpara las dos llamadas de agente invitado que leen el sistema operativo y direcciones de una VM (agent/get-osinfo,agent/network-get-interfaces). Proxmox VE 7 no tenía ese privilegio y usabaVM.Monitor; Proxmox VE 9 eliminóVM.Monitor. Sin la que conoce tu versión,guest_os_infoyguest_ip_infosimplemente no se publican para VMs; los contenedores, que no necesitan agente, conservan sus direcciones.
Lo único que el rol no cubre en absoluto es la lista de
actualizaciones pendientes (apt/update), que Proxmox protege con
Sys.Modify en /nodes — opcional, como explica el paso 6; sin él el
recolector omite node_updates_pending y node_updates_security_pending
en silencio.
(Usa -token 'dumbmonit@pve!monitor' en lugar de -user en los
comandos aclmod para un token creado con «Privilege Separation»
marcado.)
Dirección: 10.0.0.10, pve.lan, pve.lan:8006, [fd00::1] o una
URL completa https://pve.example.net. El esquema https y el puerto
8006 se añaden si faltan.
Opciones
Sección titulada «Opciones»| Clave | Etiqueta | Por defecto | Ayuda |
|---|---|---|---|
port | API port | 8006 | Se usa si la dirección no da un puerto. |
insecure_tls | Accept an unverifiable certificate | false | Proxmox viene con un certificado autofirmado por defecto: activa esto si la conexión se rechaza por ese motivo. |
request_timeout_seconds | Timeout per request (seconds) | 10 | Tiempo permitido para cada llamada a la API, de 1 a 120. |
backup_lookback_days | Backup lookback (days) | 31 | Las tareas de copia más antiguas no se examinan, de 1 a 3650. |
scan_backup_storage | Inventory backup archives | true | Escanea los almacenamientos de copia para fechar la última copia de cada máquina. Desactiva si el almacenamiento es lento en responder. |
nodes | Monitored nodes | (vacío) | Nombres de los nodos a monitorizar, separados por comas. Vacío: cada nodo del clúster. |
cluster_resources | Read the cluster inventory | true | Una llamada a /cluster/resources lista cada nodo, invitado, almacenamiento y pool. Manténlo activado: es la única fuente que todavía ve los invitados de un nodo que dejó de responder, y ahorra dos llamadas por nodo. Desactivado, el recolector recorre /nodes/{node}/qemu y /nodes/{node}/lxc en su lugar, y pierde los pools y bloqueos. |
services | Watch node services | true | /nodes/{node}/services y version: el estado de los demonios de Proxmox de cada nodo y la versión instalada en él. Un pvestatd detenido deja a todo el clúster mostrando números congelados. |
network | Watch node networking | true | /nodes/{node}/network y netstat: bridges, bonds y VLANs con su estado de enlace, más los contadores de tráfico de cada tarjeta de red de invitado. |
lvm | Watch LVM and thin pools | true | disks/lvm, disks/lvmthin y disks/directory: grupos de volúmenes, thin pools (llenado de datos y metadatos) y montajes de directorio gestionados por PVE. Necesita Sys.Audit en /; silencioso en caso contrario. |
ha | High availability | true | Lee /cluster/ha/status/current y manager_status: quórum, CRM master, la propia vista del manager de cada nodo, cada LRM con la antigüedad de su último informe, y cada recurso HA. |
backup_jobs | Scheduled backup jobs | true | Lee los jobs de Datacenter → Backup y los invitados que ningún job cubre. |
scan_snapshots | Inventory snapshots | true | Una llamada por invitado (cuatro en vuelo por nodo). Desactiva en clústeres muy grandes. |
max_snapshot_guests | Snapshot inventory limit | 200 | Los invitados más allá de este número se omiten en cada sonda y se cuentan en guest_snapshot_guests_skipped, de 1 a 10000. |
replication | Replication jobs | true | Estado de replicación de almacenamiento por nodo. Silencioso cuando el nodo no tiene job. |
ceph | Ceph health | true | Lee /cluster/ceph/status. Silencioso cuando Ceph no está instalado. |
ceph_detail | Watch Ceph in detail | true | Estado, uso y latencia por OSD, uso por pool, CephFS, flags de OSD y comprobaciones de salud silenciadas. Tres llamadas en un nodo más dos de todo el clúster, sea cual sea el tamaño del clúster. Necesita ceph activado; silencioso sin Ceph. |
backup_volumes | Check what backup jobs include | true | Para cada job programado, qué invitados cubre y cuáles de sus discos realmente escribe. Detecta un job que tiene éxito cada noche mientras omite un disco de datos. Una llamada por job. |
guest_os | Read guest OS and addresses | true | Sistema operativo y direcciones IP vistas desde dentro de cada invitado en ejecución (agente invitado QEMU para VMs, el namespace del contenedor para contenedores). Refrescado una vez por hora por invitado, no en cada sonda. Necesita VM.GuestAgent.Audit en Proxmox VE 8. |
metrics_export | Ingest the full RRD metric stream | false | Lee /cluster/metrics/export, el flujo que consumen los propios servidores de métricas de Proxmox, incluida la presión por nodo (PSI), y cada punto desde la última sonda en lugar de solo el actual. Desactivado por defecto: las series *_rrd_* que añade en parte repiten las ya recolectadas. Necesita Sys.Audit en /. |
updates | Pending updates | true | Cuenta los paquetes que lista apt/update. Necesita Sys.Modify en /nodes (ver arriba); silencioso en caso contrario. |
certificates | Certificate expiry | true | Días restantes en cada certificado de nodo (pve-ssl.pem, pveproxy-ssl.pem, pve-root-ca.pem). |
guest_agent | Ask the QEMU guest agent | true | Para cada VM en ejecución: status/current (balloon, flag de agente) y, cuando el agente está activado, agent/get-fsinfo (necesita VM.GuestAgent.Audit). Cuatro llamadas en vuelo por nodo. Silencioso cuando el agente está ausente. |
disks | Watch physical disks | true | disks/list más una llamada disks/smart por disco: salud, desgaste, temperatura. |
zfs | Watch ZFS pools | true | disks/zfs: salud, capacidad, fragmentación. Silencioso sin ZFS. |
packages | Detect package changes | true | apt/versions comparado con la sonda anterior; un cambio se reporta durante una hora en node_packages_changed. |
subscription | Watch subscription and repositories | true | subscription y apt/repositories: estado, avisos, repositorios estándar activados. |
Errores comunes
Sección titulada «Errores comunes»| Síntoma | Causa probable |
|---|---|
| Error de certificado mostrado en el monitor | Certificado autofirmado. O bien instala un certificado de confianza (ACME está integrado en Proxmox) o activa insecure_tls. La opción nunca se activa implícitamente. |
| Error de autenticación | El secret se pegó en Token ID (o al revés), «Privilege Separation» quedó marcado (el token entonces no tiene derechos), o el rol DumbMonit no se aplicó en /. |
| Falta la antigüedad de copia para un invitado | Ninguna tarea vzdump en la ventana de observación y ningún archivo encontrado en los almacenamientos; o scan_backup_storage desactivado. |
| Sondas lentas | Un almacenamiento de copia que tarda en listar, o muchos invitados que inventariar para snapshots. Desactiva scan_backup_storage o scan_snapshots, baja max_snapshot_guests, o eleva request_timeout_seconds. |
Falta node_updates_pending | Al usuario o token le falta Sys.Modify en /nodes. Concede el rol DumbMonitUpdates del paso 6, o ignóralo: node_pve_packages_upgradable y node_reboot_required cubren los paquetes de Proxmox sin él. |
| Sin porcentaje de memoria para una VM | Proxmox VE 9 reporta, en el inventario de clúster, la memoria que toma la VM en el host — sobrecarga incluida, así que regularmente por encima de su asignación. Un porcentaje calculado a partir de ella estaría por encima del 100% para siempre. La cifra honesta viene del driver balloon dentro del invitado; una VM con el ballooning desactivado por tanto muestra bytes y ningún porcentaje. guest_memory_host_bytes es la cifra del lado del host. |
| Sin capacidad para el almacenamiento de copia | Un datastore de Proxmox Backup Server montado en PVE no reporta tamaño: PVE no lo lee. La propia página del monitor del datastore lo tiene. |
| Uso de disco vacío («size only») para una VM | La VM no tiene agente invitado QEMU (no activado en sus opciones, o qemu-guest-agent no instalado dentro), o al token le falta VM.GuestAgent.Audit. guest_agent_enabled y guest_agent_running dicen cuál. Los contenedores nunca lo necesitan. |
Sin ninguna serie node_disk_* | Al token le falta Sys.Audit en / (el rol DumbMonit lo concede), o el nodo se ejecuta detrás de un controlador RAID que oculta SMART: disks/list entonces reporta UNKNOWN y no se publica ningún node_disk_smart_failed. |
node_packages_changed se activa tras un reinicio del servidor | No lo hace: la primera sonda tras un reinicio solo aprende las versiones. Un cambio se reporta solo entre dos sondas consecutivas del mismo proceso de servidor. |
Falta backup_job_last_ok{job=…} mientras existe backup_job_last_ok{node=…} | Las tareas vzdump no llevan el id del job (Proxmox VE anterior a 7.2, o jobs ejecutados a mano). El estado de ejecución por nodo sigue estando ahí. |
| Sin métricas de Ceph ni replicación | Nada que reportar: Ceph no está instalado, o no hay ningún job de replicación configurado. No es un error. |
| Sin thin pool ni grupo de volúmenes en una tarjeta de nodo | La opción lvm está desactivada, el nodo no tiene LVM, o el usuario solo tiene Sys.Audit en /nodes — ese inventario lo pide en /. |
| Falta la sección Ceph mientras el clúster tiene Ceph | ceph o ceph_detail está desactivado, o cada nodo respondió a las llamadas de detalle con un error. available: false en /api/targets/{id}/proxmox/ceph significa «no hay Ceph aquí», no «aún no recolectado». |
| Sin sistema operativo ni dirección IP para una VM | El agente invitado QEMU no está activado ni instalado en esa VM, o al token le falta VM.GuestAgent.Audit en Proxmox VE 8 (paso 7). Los contenedores no necesitan ningún agente. Un invitado que acaba de arrancar espera hasta una hora: los datos se refrescan cada hora, no en cada sonda. |
| Un invitado conserva una insignia de bloqueo | Una copia, migración o snapshot interrumpida lo dejó atrás. qm unlock <vmid> para una VM, pct unlock <vmid> para un contenedor — tras comprobar que el job realmente terminó. |
pve_backup_excludes_disk se activa en una máquina con un CD-ROM | No lo hace: las unidades, imágenes cloudinit y entradas que no son volúmenes se excluyen por diseño y nunca se reportan por invitado. Lo que se activó es un disco real con backup=0. |
Sin ninguna serie *_rrd_* | metrics_export está desactivado (lo está por defecto), o al usuario le falta Sys.Audit en /. |