
Proxmox Backup Server
Server di backup: un calendario di backup su trenta giorni per macchina, task falliti con i loro log, job pianificati (sync, verify, prune, garbage collection), datastore, dischi e pool ZFS, aggiornamenti in attesa, i servizi e le versioni dei pacchetti del server stesso, e il livello tape quando presente.
La pagina del monitor
Sezione intitolata “La pagina del monitor”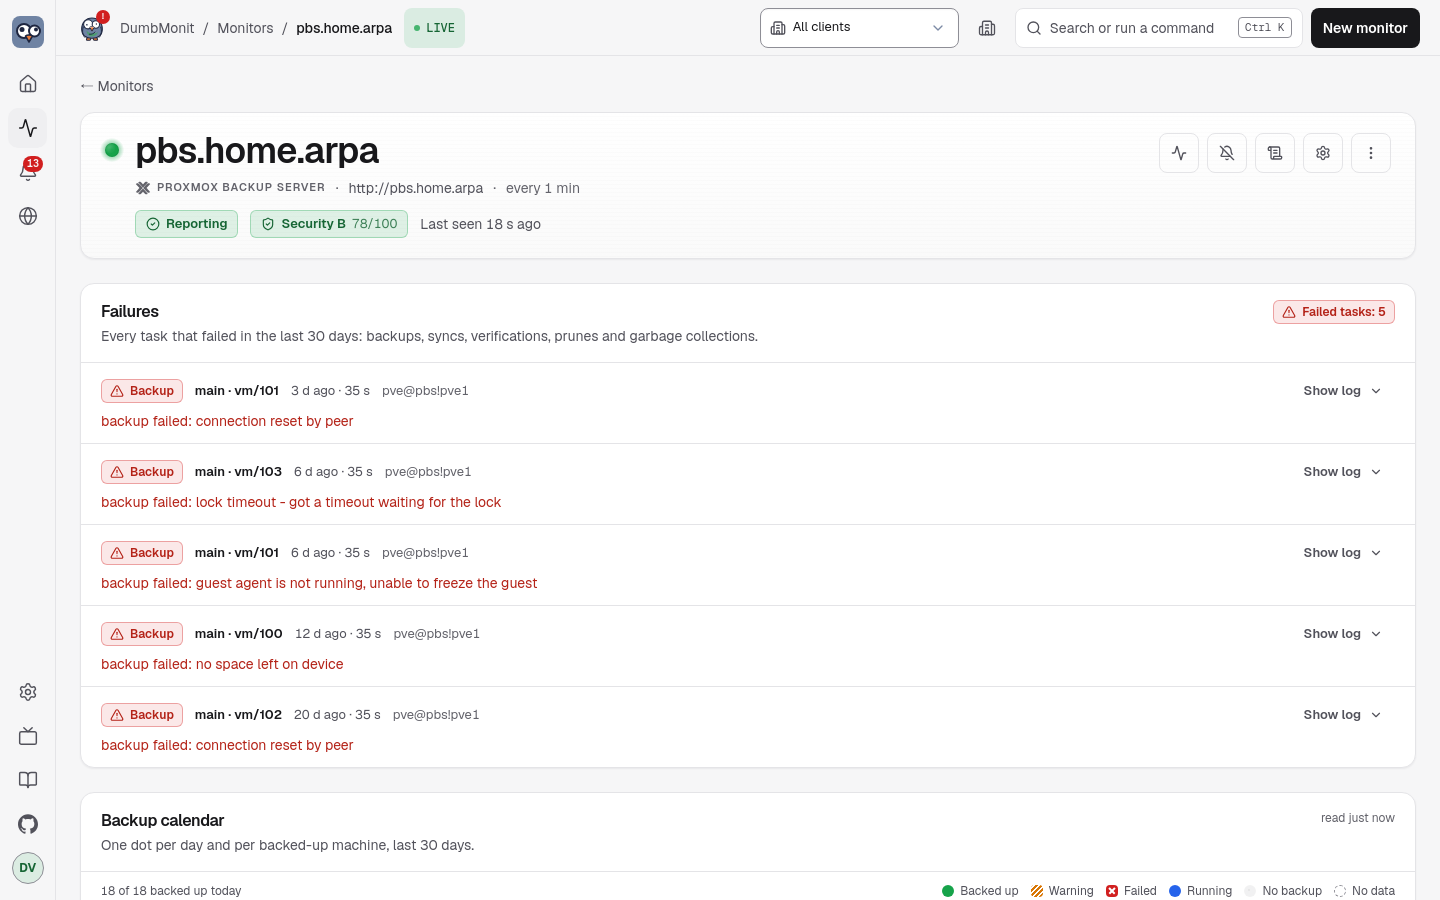
Oltre ai grafici generici, un monitor PBS mostra sei pannelli, letti da ciò che la sonda ha memorizzato — aprire la pagina non interroga mai PBS stesso:
- Failures — ogni task fallito negli ultimi 30 giorni (backup,
sync, verify, prune, GC), il più recente prima, con il suo tipo,
cosa bersagliava, quando è iniziato e il messaggio di errore proprio
di PBS. Show log recupera le ultime righe del log del task da PBS
su richiesta (
/nodes/localhost/tasks/{upid}/log). - Backup calendar — una riga per macchina sottoposta a backup
(datastore, namespace,
type/id, e il nome del guest quando PVE lo ha scritto nelle note dello snapshot), un punto per giorno: verde acqua quando un backup è riuscito quel giorno (un task è terminatoOK, oppure esiste uno snapshot — i gruppi sincronizzati non hanno task locale), rosso quando un task di backup è fallito e nessuno è riuscito, ambra quando il backup c’è ma la sua verifica è fallita, blu mentre uno è in corso, grigio quando non è accaduto nulla. Il tooltip di ogni punto dà l’ora, la dimensione, la durata e un estratto dell’errore; la riga dice quando sono stati l’ultimo successo e l’ultimo fallimento, il conteggio degli snapshot, la dimensione dell’ultimo snapshot e la retention del job di prune che si applica. Una macchina i cui backup falliscono tutti non ha alcuno snapshot affatto e appare comunque — dai suoi task. - Jobs — ogni job di sync, verify e prune e il GC di ogni datastore, con pianificazione, ultima esecuzione, esito, prossima esecuzione; un’ultima esecuzione fallita ottiene una targhetta rossa e il testo dell’errore, i fallimenti vengono ordinati prima.
- Tape — solo quando il server ha un livello tape. Job di backup tape con il loro pool, drive, l’etichetta della prossima tape attesa, l’ultima esecuzione e il suo errore; pool di media con le loro policy di allocazione e retention, quante tape contengono, quante sono scadute e se sono cifrate; drive e changer; e le tape stesse con il loro stato, media set, posizione e byte scritti.
- Datastores and disks — barra di utilizzo, previsione di
riempimento propria di PBS, fattore di deduplica, ultimo GC; pool
ZFS con il loro stato di salute; dischi fisici con il verdetto SMART
e l’usura SSD, e la tabella SMART completa su richiesta
(
/nodes/localhost/disks/smart). Per datastore mostra anche una targhetta di manutenzione o “Not mounted”, una targhetta “Busy: n writes, n reads”, la crescita misurata al giorno e su quanti giorni di cronologia, quante macchine di ogni tipo contiene, quanto è durato l’ultimo GC, e una riga di avviso quando quel GC ha trovato chunk illeggibili. - Server — le unità systemd, con quelle di cui il server non può fare a meno segnalate; le versioni dei pacchetti Proxmox (installata, disponibile, in esecuzione), con una targhetta “Restart pending” quando il demone è indietro rispetto al suo pacchetto; il certificato e la sua scadenza; e le regole di traffic control con i loro limiti e cosa stanno portando.
Il calendario divide i giorni alla mezzanotte locale del browser. La
sua cronologia proviene dall’elenco dei task: la prima sonda dopo un
avvio legge gli ultimi 30 giorni
(/nodes/localhost/tasks?since=…&limit=5000), le sonde successive
leggono solo la finestra dei task, e il server mantiene l’unione in
SQLite (pbs_task_history, 35 giorni, al massimo 10.000 task per
monitor) così il calendario sopravvive ai riavvii.
Cosa controlla
Sezione intitolata “Cosa controlla”Tutte le metriche hanno il prefisso dumbmonit_pbs_.
| Famiglia | Metriche | Etichette |
|---|---|---|
| Nodo | node_cpu_percent, node_cpu_count, node_iowait_percent (tempo CPU in attesa di I/O — su un server di backup è ciò che dice che i dischi sono saturi), node_load1/5/15, node_memory_used/total/free_bytes, node_memory_used_percent, node_swap_used/total_bytes, node_rootfs_used/total/avail_bytes, node_rootfs_percent, node_uptime_seconds, node_kernel_info, version_info | |
| Datastore | datastore_available, datastore_bytes_used/total/avail, datastore_used_percent, datastore_estimated_full_seconds (stima propria di PBS; assente mentre manca il dato o l’utilizzo diminuisce), datastore_dedup_factor, datastore_removable_unmounted (1 quando un datastore removibile è notmounted — non un errore, semplicemente non è collegato; etichetta mount_status), datastore_backend_info (etichetta backend, filesystem o s3), datastore_maintenance (1 quando il datastore è bloccato per manutenzione; etichetta mode, offline, read-only…), datastore_groups e datastore_snapshots (etichetta type, vm/ct/host/other), datastore_active_reads, datastore_active_writes (cosa sta bloccando il datastore in questo momento — questo spiega una garbage collection che non termina), datastore_growth_percent_per_day, datastore_growth_bytes_per_day, datastore_history_days | datastore |
| Garbage collection | gc_last_removed_bytes, gc_last_pending_bytes, gc_last_run_ok (PBS 3.3+), gc_last_success_age_seconds, gc_last_duration_seconds, gc_disk_chunks, gc_last_pending_chunks, gc_last_removed_chunks, gc_bad_chunks (chunk che il GC ha trovato illeggibili e lasciato al loro posto — corruzione, non spazio da recuperare: un backup che li referenzia non può più essere ripristinato), verify_last_success_age_seconds, sync_last_success_age_seconds | datastore |
| Gruppi di backup | backup_count, backup_last_timestamp_seconds, backup_last_age_seconds, backup_last_size_bytes, backup_last_verified (1 verificato, 0 fallito, assente se mai verificato) | datastore, namespace, backup_type, group |
| Namespace | namespace_groups, namespace_snapshots (il namespace root è namespace="") | datastore, namespace |
| Task nella finestra | tasks_running, tasks_ok, tasks_failed | worktype (backup, verificationjob, garbage_collection, prune, syncjob…) |
| Job | job_enabled, job_last_ok (1 per OK o WARNINGS: n, 0 altrimenti, assente se il job non è mai stato eseguito), job_never_run (1 quando un job è abilitato, ha una pianificazione e non è mai stato eseguito — non ha né un fallimento né un successo, quindi è invisibile ovunque altro), job_last_run_age_seconds, job_next_run_seconds (negativo quando scaduto), sync_jobs_total, verify_jobs_total, prune_jobs_total; alias sync_job_last_ok per la regola | job, datastore, kind (sync, verify, prune); remote (remote:remote-store, o local) sui job sync — l’alias porta job, datastore, remote |
Tape (opzione tape, disattivata per impostazione predefinita, cinque chiamate) | tape_backup_job_last_ok, tape_backup_job_never_run, tape_backup_job_last_run_age_seconds, tape_backup_job_next_run_seconds, tape_backup_jobs_total; tape_drive_info (serie di presenza), tape_drives_total, tape_changers_total, tape_media_pools_total; tape_media_total, tape_media_writable, tape_media_expired, tape_media_bytes_used | job, datastore, pool, drive sui job; drive, vendor, model, changer su tape_drive_info; pool sui conteggi dei media |
| Dischi (stessi nomi di Proxmox VE) | node_disk_size_bytes, node_disk_smart_failed (0 passed, 1 failed; assente quando SMART non ha dato un verdetto), node_disk_health_info (serie di presenza; etichette health, serial, used), node_disk_wearout_percent (resistenza usata, solo SSD, come la mostra PBS: 100 − wearout) | disk (/dev/sda), model, type |
| Pool ZFS (stessi nomi di Proxmox VE) | node_zfs_pool_degraded (0 ONLINE, 1 altrimenti), node_zfs_pool_health_info (etichetta health), node_zfs_pool_size_bytes, node_zfs_pool_alloc_bytes, node_zfs_pool_free_bytes, node_zfs_pool_used_percent, node_zfs_pool_fragmentation_percent | pool |
| Aggiornamenti | node_updates_pending (numero di pacchetti con un aggiornamento disponibile) | |
Versioni (opzione updates, da /nodes/localhost/apt/versions) | node_package_upgradable (1/0), node_package_info (serie di presenza; etichette installed, available, running), node_running_version_stale (1 quando il pacchetto proxmox-backup-server installato non è più il demone in esecuzione — il pacchetto è stato aggiornato, i servizi non sono stati riavviati) | package, limitato a proxmox-backup, proxmox-backup-server, proxmox-backup-client, proxmox-kernel-helper |
Servizi (opzione services, una chiamata) | node_service_active (1 in esecuzione, 0 no), node_service_enabled (assente per un’unità static, che un’altra unità richiama e che quindi non è né abilitata né disabilitata), node_services_total | service, expected ("1" per proxmox-backup, proxmox-backup-proxy e proxmox-backup-banner, le unità di cui il server non può fare a meno; ogni altra unità ottiene comunque la sua serie, con expected="0", e non genera mai un avviso) |
Certificato (opzione certificates, disattivata per impostazione predefinita) | node_certificate_expires_seconds, negativo una volta scaduto | certificate (il nome del file), issuer |
Traffic control (opzione traffic_control) | traffic_rate_in_bytes, traffic_rate_out_bytes (misurati all’istante della sonda), traffic_limit_in_bytes, traffic_limit_out_bytes (il limite configurato, analizzato dalle stringhe decimali di PBS come 100 MB; assente quando quella direzione non ha limite, invece di uno zero che si leggerebbe come “tutto è bloccato”), traffic_rules_total | rule |
| Limiti e raccolta | backup_groups_total, backup_groups_dropped, up, scrape_errors, scrape_duration_seconds |
Un task che termina con WARNINGS: n conta come riuscito. Le chiamate
per datastore sono limitate a quattro in parallelo: elencare gli
snapshot legge gli indici del datastore, e un picco rallenterebbe il
backup in corso.
Gli elenchi di job non sono limitati alla finestra dei task: un job di
sync che fallisce da tre settimane viene comunque riportato come
fallito. Un job che non è mai stato eseguito non ha una serie
job_last_ok, ma ottiene job_never_run, e la regola “PBS job never
ran” si attiva esattamente in quel caso.
La garbage collection viene letta con una singola chiamata /admin/gc
che copre ogni datastore in una volta, dove prima richiedeva una
/admin/datastore/{store}/gc per datastore; quella chiamata per
datastore resta come ripiego quando /admin/gc non è disponibile — un
PBS più vecchio, o un privilegio mancante — e non viene contata come un
errore. /admin/gc porta anche la durata dell’esecuzione e i contatori
di chunk che la chiamata per datastore non porta. gc_last_run_ok
proviene da last-run-state su PBS 3.3 e successivi; su versioni più
vecchie ricade sul task di garbage collection più recente della
finestra. I conteggi per tipo provengono da
/admin/datastore/{store}/status?verbose=1: senza verbose, PBS
restituisce solo le dimensioni, che /status/datastore-usage già dava.
/admin/datastore/{store}/namespace restituisce l’intero albero del
namespace, così nulla viene perso nei sotto-namespace —
pve/site-a/rack1 viene contato come il root. I dischi e i pool
provengono da /nodes/localhost/disks/list e
/nodes/localhost/disks/zfs (opzione disks; un 403 è tollerato, e
così è il 400 che un server senza ZFS risponde: nessuna serie di pool,
nessun errore di raccolta).
datastore_growth_percent_per_day è un fit ai minimi quadrati sulla
cronologia di utilizzo che PBS stesso restituisce con
/status/datastore-usage: una frazione di utilizzo tra 0 e 1, un
punto ogni trenta minuti nell’ultimo mese, con buchi null che vengono
saltati invece che riempiti — un server che era spento non è cresciuto
mentre era spento. Questi sono gli stessi numeri dietro la previsione
“full in N days” propria di PBS. Sono necessari almeno otto punti
misurati prima che venga pubblicato qualcosa, e datastore_history_days
dice quanta cronologia coprono la pendenza. Un valore negativo non è un
guasto: il prune sta recuperando più di quanto i backup aggiungano.
Nulla affatto viene pubblicato per la tape quando il server non ha drive, changer, pool o job tape: un’installazione senza tape non deve far crescere una dozzina di serie a zero che si leggono come un livello tape in difficoltà. Una tape che non appartiene a nessun pool, media vuoto o media ritirato da un pool, non è in alcun conteggio di pool.
Dispositivi
Sezione intitolata “Dispositivi”Ogni macchina sottoposta a backup — host, VM o container — viene anche
pubblicata sotto la famiglia generica condivisa da ogni integrazione
DumbMonit che traccia i dispositivi protetti —
dumbmonit_client_device_*, con prefisso senza pbs, documentata per
intero sotto Dispositivi client.
Nulla di nuovo viene chiesto a PBS: è la stessa data dell’ultimo
snapshot già dietro backup_last_timestamp_seconds, ripubblicata sotto
la famiglia condivisa così che una regola e una tabella servano PBS
insieme a ogni altra integrazione che protegge un dispositivo.
| Metrica | Cosa | Etichette |
|---|---|---|
last_backup_timestamp_seconds | Stesso istante di backup_last_timestamp_seconds per quel gruppo | device, type, os, user, kind |
stale_seconds | Positivo una volta che un gruppo ha superato device_stale_days (3 per impostazione predefinita) senza un nuovo snapshot; guida la regola Client device stale | device, type, os, user, kind, signal (sempre backup) |
Limite da conoscere: PBS non registra una “connessione” separata
per una macchina sottoposta a backup, solo i backup —
last_seen_timestamp_seconds e il segnale connection non vengono mai
pubblicati qui; un dispositivo mostra last_connection come ”—” nella
tabella della pagina del monitor. Il monitor nominato
nell’avviso è il nome del guest dalle note dello snapshot quando PVE ne
ha scritto uno, altrimenti type/id, come il calendario di backup.
Le regole integrate che si applicano: Monitor unreachable, PBS datastore almost full, PBS datastore filling up, PBS backup too old (per gruppo di backup: nessun nuovo snapshot per due giorni — modifica la soglia della regola per una finestra più lunga), PBS backup verification failed, PBS task failed, PBS garbage collection too old, PBS garbage collection failed, PBS corrupt chunks found, PBS sync job failed, PBS prune job failed, PBS verification job failed, PBS job never ran, PBS datastore not mounted, PBS service down, PBS restart pending after upgrade, PBS certificate expiring, PBS tape backup failed, PBS disk SMART failure, PBS SSD worn out, PBS ZFS pool degraded, PBS updates pending, Client device stale. Le notifiche nominano il job, il datastore o il gruppo di backup interessato.
Cosa preparare in PBS
Sezione intitolata “Cosa preparare in PBS”I passaggi seguenti sono quelli mostrati dalla nota accanto al modulo. Il principio: un utente riservato al monitoraggio, un token con un ruolo di sola lettura — mai l’account con cui accedi.
-
Apri una shell sul server di backup (nell’interfaccia web: Administration → Shell; oppure SSH) e crea un utente riservato al monitoraggio. Non ha bisogno di una password: il token è ciò che accede.
proxmox-backup-manager user create dumbmonit@pbs --comment "DumbMonit monitoring" -
Crea il token API dell’utente. Il comando stampa l’id del token e il suo secret: copia entrambi subito, PBS non mostra più il secret.
proxmox-backup-manager user generate-token dumbmonit@pbs monitor -
Dai il minimo di sola lettura, per percorso — al token e all’utente che lo possiede. I privilegi effettivi di un token sono l’intersezione della sua propria ACL e di quella del suo utente: concessi solo al token, non ammontano a nulla, e PBS non lo riporta da nessuna parte. Ogni riga viene quindi scritta due volte.
DatastoreAuditsu/datastore(Datastore.Audit) legge i datastore, gli snapshot, i job di verify e prune e il GC;Auditsu/system(Sys.Audit) legge lo stato del nodo, l’elenco dei task e i log dei task, i servizi, le regole di traffic control, i dischi e i pool ZFS.proxmox-backup-manager acl update /datastore DatastoreAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /datastore DatastoreAudit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update /system Audit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /system Audit --auth-id 'dumbmonit@pbs!monitor'Opzionale, e anche questo due volte.
RemoteAuditsu/remote(Remote.Audit) mostra i job di sync che recuperano da un remote: il ruolo integratoAuditcopre soloSys.AuditeDatastore.Audit, e senzaRemote.Audittale job non viene rifiutato, è semplicemente assente dall’elenco dei job.TapeAuditsu/tape(Tape.Audit) legge il livello tape.Auditsu/(Sys.Audital livello superiore) elenca gli aggiornamenti di pacchetto in attesa, e copre anche/datastoree/systemse preferisci meno righe. Senza di essi quegli elementi vengono saltati silenziosamente, nulla altro cambia. Nulla qui può scrivere: il collector esegue soloGET.proxmox-backup-manager acl update /remote RemoteAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /remote RemoteAudit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update /tape TapeAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /tape TapeAudit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update / Audit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update / Audit --auth-id 'dumbmonit@pbs!monitor' -
Prima di lasciare la shell, verifica cosa il token può effettivamente leggere. Il comando stampa i suoi privilegi effettivi, percorso per percorso; un risultato vuoto significa che all’utente manca l’ACL che ha il token — il caso in cui il monitor appare perfettamente vivo e non riporta nulla.
proxmox-backup-manager user permissions 'dumbmonit@pbs!monitor' -
Copia l’id del token nel campo Token ID di DumbMonit e il secret nel suo campo Secret.
dumbmonit@pbs!monitor -
Preferisci l’interfaccia web? Configuration → Access Control: Users → Add, poi API Tokens → Add, poi Permissions → Add. Aggiungi ogni permesso due volte, una come User Permission per
dumbmonit@pbse una come API Token Permission perdumbmonit@pbs!monitor: con percorso/datastoree ruoloDatastoreAudit, poi di nuovo con percorso/systeme ruoloAudit. Un permesso solo sul token non concede nulla. -
In DumbMonit, inserisci l’indirizzo del server, per esempio “pbs.lan” oppure “pbs.lan:8007”.
Documentazione del fornitore: PBS API tokens.
Credenziali
Sezione intitolata “Credenziali”| Credenziale | Campi |
|---|---|
| API token (consigliato) | Token ID: utente, realm e nome del token come li mostra PBS, dumbmonit@pbs!monitor. Secret: l’UUID mostrato una volta alla creazione del token. DumbMonit li invia come l’header PBSAPIToken=user@pbs!name:secret che PBS si aspetta. |
| Username / password | user@pbs (oppure @pam) e la password. Un ticket viene ottenuto, memorizzato in cache e rinnovato dieci minuti prima della sua scadenza di due ore. |
L’API accetta il token in due pezzi (token_id + secret) oppure,
come facevano le versioni più vecchie, come una stringa singola
token = user@pbs!name=secret; entrambi vengono memorizzati nello
stesso modo. Un token completo incollato in Token ID viene separato
dal modulo.
Diritti, di sola lettura, e concessi due volte: i privilegi effettivi
di un token sono l’intersezione della sua propria ACL e di quella del
suo utente, quindi ogni ruolo sotto deve essere dato sia a
dumbmonit@pbs che a dumbmonit@pbs!monitor. Più semplice: il ruolo
integrato Audit su /, più RemoteAudit su /remote per i job di
sync e TapeAudit su /tape per il livello tape — Audit copre solo
Sys.Audit e Datastore.Audit, e quei due ruoli esistono precisamente
perché non lo fa. Per endpoint:
| Endpoint | Richiede |
|---|---|
GET /version | qualsiasi utente autenticato |
GET /nodes/localhost/status, GET /nodes/localhost/tasks, GET /nodes/localhost/tasks/{upid}/log | Sys.Audit su /system (Audit su /system) |
GET /nodes/localhost/disks/list, …/disks/smart, …/disks/zfs | Sys.Audit su /system (Audit su /system); un 403 è tollerato: nessuna serie di disco, nessun errore di raccolta. …/disks/zfs risponde 400 su un server senza ZFS, tollerato nello stesso modo |
GET /nodes/localhost/services, GET /admin/traffic-control | Sys.Audit su /system (Audit su /system); un 403 è tollerato: nessuna serie, nessun errore di raccolta |
GET /nodes/localhost/certificates/info | Sys.Modify su /system — un privilegio di scrittura, ragione per cui l’opzione certificates è disattivata per impostazione predefinita e per cui un token di monitoraggio non dovrebbe averlo |
GET /status/datastore-usage, GET /admin/gc, GET /config/datastore, GET /admin/datastore/{store}/gc, …/status, …/active-operations, …/namespace, …/snapshots | Datastore.Audit su /datastore/{store} (DatastoreAudit su /datastore) |
GET /admin/verify, GET /admin/prune | elencati per i datastore dove il token ha Datastore.Audit; altri job vengono omessi silenziosamente |
GET /admin/sync | Datastore.Audit sul datastore e Remote.Audit su /remote/{remote} (RemoteAudit su /remote); altri job vengono omessi silenziosamente |
GET /nodes/localhost/apt/update, …/apt/versions | Sys.Audit su / (Audit su /); un 403 è tollerato: nessuna serie di aggiornamento o versione, nessun errore di raccolta |
GET /tape/backup, /tape/drive, /tape/changer, /config/media-pool, /tape/media/list | Tape.Audit su /tape (TapeAudit su /tape); ogni fallimento è tollerato, un PBS senza supporto tape incluso: nessuna serie tape, nessun errore di raccolta |
Nota che Audit su /system da solo non copre l’elenco di
aggiornamenti, che PBS controlla al percorso radice. Un 403 sugli
elenchi di job o l’elenco di aggiornamenti viene trattato come un
privilegio opzionale: nulla viene prodotto e nulla viene contato in
scrape_errors. E un ruolo mancante sull’utente è peggio di un 403:
la chiamata riesce e restituisce un elenco vuoto, così nulla viene
prodotto e nulla si lamenta nemmeno.
Indirizzo: 10.0.0.20, pbs.lan, pbs.lan:8007, [fd00::2] oppure un
URL completo. Lo schema https e la porta 8007 vengono aggiunti se
mancanti.
Opzioni
Sezione intitolata “Opzioni”| Chiave | Etichetta | Predefinito | Aiuto |
|---|---|---|---|
port | API port | 8007 | Usata se l’indirizzo non fornisce una porta. |
insecure_tls | Accept an unverifiable certificate | false | Proxmox Backup Server fornisce un certificato autofirmato per impostazione predefinita: abilita questo se la connessione viene rifiutata per questo motivo. |
request_timeout_seconds | Timeout per request (seconds) | 15 | Tempo consentito per ogni chiamata API, da 1 a 120. Elencare gli snapshot di un grande datastore può richiedere diversi secondi. |
task_lookback_hours | Task window (hours) | 24 | I task più vecchi non vengono contati tra i fallimenti, da 1 a 8760. |
datastores | Monitored datastores | (vuoto) | Nomi dei datastore da monitorare, separati da virgole. Vuoto: ogni datastore. |
max_groups | Backup group limit | 500 | Numero massimo di macchine sottoposte a backup che producono serie; oltre, le più vecchie vengono ignorate. Da 1 a 100000. |
jobs | Watch scheduled jobs | true | Elenca i job di sync, verify e prune e la loro ultima esecuzione (/admin/sync, /admin/verify, /admin/prune). |
updates | Watch pending updates | true | Conta i pacchetti con un aggiornamento disponibile (/nodes/localhost/apt/update). |
disks | Watch disks and ZFS pools | true | Legge i dischi fisici (verdetto SMART, usura SSD) e i pool ZFS (/nodes/localhost/disks). |
services | Watch the server’s services | true | Legge le unità systemd e riporta se quelle di cui il server non può fare a meno sono in esecuzione. Richiede Sys.Audit su /system; saltato silenziosamente altrimenti. |
datastore_details | Read datastore detail | true | Due chiamate in più per datastore: quante macchine e snapshot contiene, cosa lo sta leggendo o scrivendo in questo momento, e se è bloccato per manutenzione. |
traffic_control | Watch traffic limits | true | Legge i limiti di tasso e cosa stanno portando in questo momento. Richiede Sys.Audit; saltato silenziosamente altrimenti. |
certificates | Watch certificate expiry | false | Disattivata per impostazione predefinita: PBS protegge questa chiamata dietro Sys.Modify, un privilegio di scrittura che un token di monitoraggio non dovrebbe avere. |
tape | Watch tape backups | false | Legge il livello tape. Disattivata per impostazione predefinita, poiché la maggior parte delle installazioni non ha hardware tape. Richiede Tape.Audit su /tape. |
device_stale_days | Device staleness (days) | 3 | Una macchina sottoposta a backup senza un nuovo snapshot per più tempo di questo viene segnalata obsoleta. Da 1 a 90. |
Errori comuni
Sezione intitolata “Errori comuni”| Sintomo | Causa probabile |
|---|---|
| Errore di certificato | Certificato autofirmato: installane uno fidato (ACME è integrato in PBS) oppure abilita insecure_tls. |
| Errore di autenticazione | Il secret è stato incollato in Token ID (o il contrario), oppure il token non ha permesso Audit — più spesso perché il ruolo è stato concesso al token ma non all’utente che lo possiede, cosa che non fallisce: le chiamate riescono e restituiscono elenchi vuoti. Solo il fallimento di GET /version condanna l’intera sonda; qualsiasi altra chiamata fallita viene contata in scrape_errors. |
| Tutto si legge vuoto ma il monitor è attivo | All’utente manca l’ACL che ha il token, e PBS fa l’intersezione dei due: proxmox-backup-manager user permissions 'dumbmonit@pbs!monitor' non stampa nulla. Concedi ogni ruolo anche a dumbmonit@pbs. |
Nessuna serie node_updates_pending | Al token manca Sys.Audit su /: dagli il ruolo Audit su /, oppure imposta updates su false per fermare la richiesta. |
| Un job di sync manca | Al token manca Remote.Audit sul remote del job: aggiungi il ruolo RemoteAudit su /remote. Il job non viene rifiutato, è semplicemente assente dall’elenco. |
| Nessuna scadenza di certificato | L’opzione certificates è disattivata, che è il predefinito: PBS richiede Sys.Modify per quella chiamata, un privilegio di scrittura. |
| Il pannello Tape non appare mai | L’opzione tape è disattivata, che è il predefinito, oppure il server non ha drive, changer, pool o job tape. Nulla viene pubblicato quando non c’è nulla. |
| Nessun valore di crescita su un datastore | La cronologia di utilizzo di PBS ha meno di otto punti misurati; si riempie nei primi giorni. |
| “PBS datastore filling up” non si attiva mai | datastore_estimated_full_seconds viene calcolato da PBS da un mese di misurazioni ed è assente finché non lo è. |
| Gruppi mancanti | Più di max_groups macchine sottoposte a backup: backup_groups_dropped dice quante sono state escluse. |
| Il calendario è vuoto o corto | Si riempie dall’elenco dei task alla prima sonda dopo un avvio (ultimi 30 giorni); un PBS il cui archivio dei task è stato pulito mostra solo ciò che resta. Una macchina che non è mai stata sottoposta a backup su questo server e non ha mai avuto un task non ha alcuna riga. |
Una macchina appare come vm/104 senza il suo nome | PVE scrive il nome del guest nelle note dello snapshot solo con il template di note predefinito ({{guestname}}); un template personalizzato o un PVE più vecchio lascia le note vuote. |
| “Show log” fallisce | Al token manca Sys.Audit su /system per il log del task, oppure PBS ha già ruotato il log di un vecchio task. |