
Proxmox Backup Server
Servidor de cópias de segurança: um calendário de cópias de segurança de trinta dias por máquina, tarefas falhadas com os seus registos, tarefas agendadas (sync, verify, prune, garbage collection), datastores, discos e pools ZFS, atualizações pendentes, os serviços e versões de pacote do próprio servidor, e o nível de fita quando existe um.
A página do monitor
Seção intitulada “A página do monitor”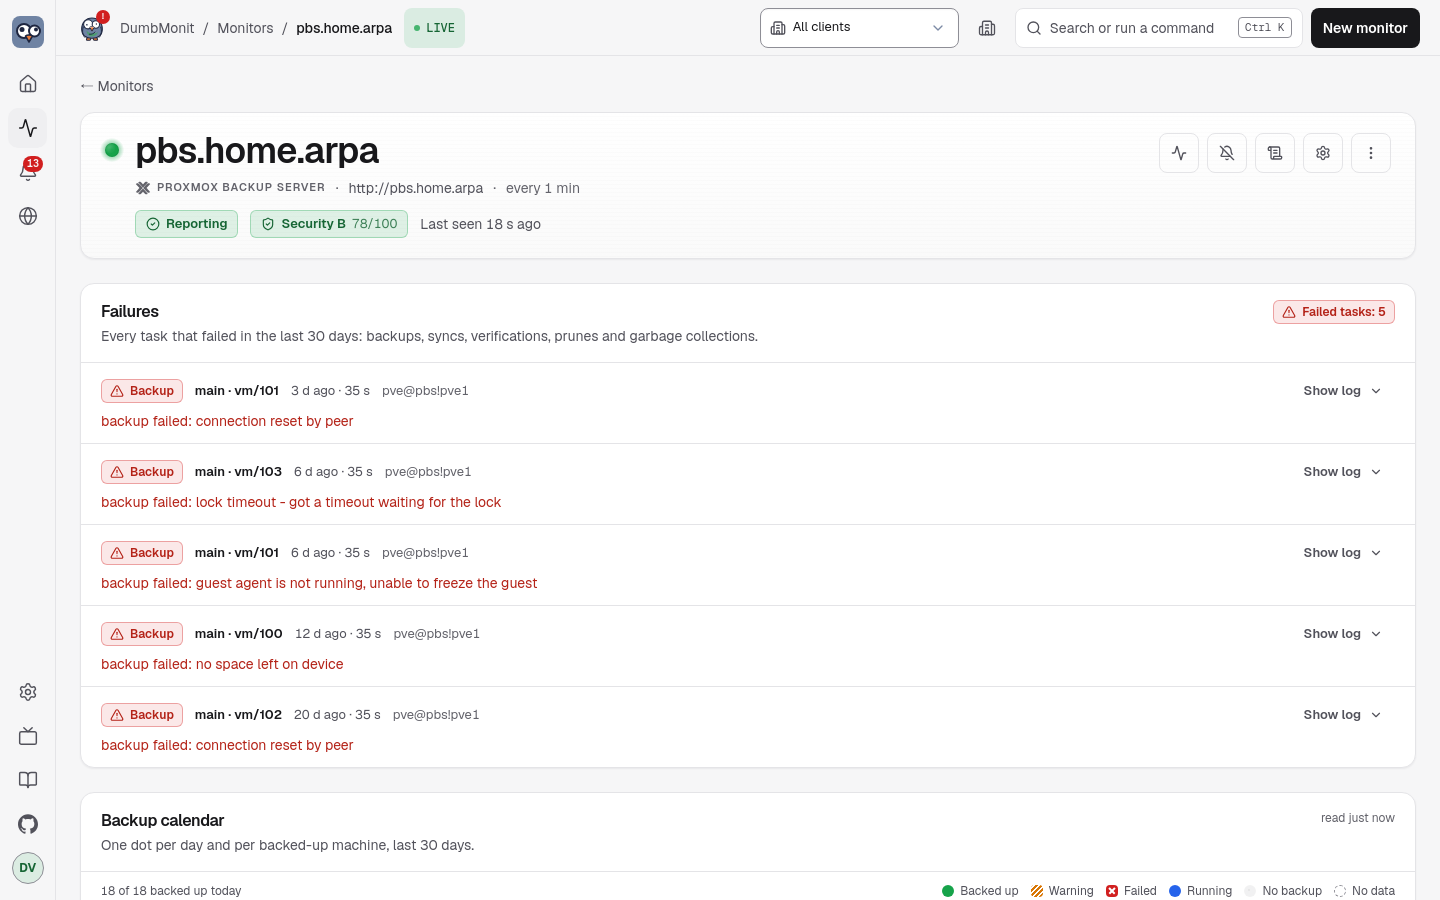
Além dos gráficos genéricos, um monitor PBS mostra seis painéis, lidos do que a verificação guardou — abrir a página nunca consulta o próprio PBS:
- Failures — cada tarefa que falhou nos últimos 30 dias (backup,
sync, verify, prune, GC), a mais recente primeiro, com o seu tipo, o
que visou, quando começou e a própria mensagem de erro do PBS.
Show log obtém as últimas linhas do registo da tarefa a partir do
PBS a pedido (
/nodes/localhost/tasks/{upid}/log). - Backup calendar — uma linha por máquina com cópia de segurança
(datastore, namespace,
type/id, e o nome do convidado quando o PVE o escreveu nas notas do snapshot), um ponto por dia: turquesa quando uma cópia de segurança teve sucesso nesse dia (uma tarefa terminouOK, ou existe um snapshot — grupos sincronizados não têm tarefa local), vermelho quando uma tarefa de cópia de segurança falhou e nenhuma teve sucesso, âmbar quando a cópia de segurança existe mas a sua verificação falhou, azul enquanto uma está em execução, cinza quando nada aconteceu. A dica de cada ponto dá a hora, tamanho, duração e um excerto do erro; a linha diz quando foram o último sucesso e a última falha, a contagem de snapshots, o tamanho do snapshot mais recente e a retenção da tarefa de prune que se aplica. Uma máquina cujas cópias de segurança todas falham não tem nenhum snapshot e ainda aparece — a partir das suas tarefas. - Jobs — cada tarefa de sync, verify e prune e o GC de cada datastore, com calendário, última execução, resultado, próxima execução; uma última execução falhada recebe uma placa vermelha e o texto de erro, as falhas ordenam-se primeiro.
- Tape — só quando o servidor tem um nível de fita. Tarefas de cópia de segurança em fita com a sua pool, drive, o rótulo da próxima fita esperada, a última execução e o seu erro; pools de media com as suas políticas de alocação e retenção, quantas fitas contêm, quantas expiraram e se estão encriptadas; drives e changers; e as próprias fitas com o seu estado, media set, localização e bytes escritos.
- Datastores and disks — barra de utilização, a própria previsão
de enchimento do PBS, fator de deduplicação, último GC; pools ZFS
com a sua saúde; discos físicos com o veredicto SMART e desgaste de
SSD, e a tabela SMART completa a pedido
(
/nodes/localhost/disks/smart). Por datastore também mostra uma placa de manutenção ou «Not mounted», uma placa «Busy: n writes, n reads», o crescimento medido por dia e sobre quantos dias de histórico, quantas máquinas de cada tipo contém, quanto tempo demorou o último GC, e uma linha de aviso quando esse GC encontrou chunks ilegíveis. - Server — as unidades systemd, com as que o servidor não pode passar sem destacadas; as versões de pacote Proxmox (instalada, disponível, em execução), com uma placa «Restart pending» quando o daemon está atrás do seu pacote; o certificado e a sua expiração; e as regras de controlo de tráfego com os seus limites e o que estão a transportar.
O calendário divide os dias à meia-noite local do navegador. O seu
histórico vem da lista de tarefas: a primeira verificação depois de um
arranque lê os últimos 30 dias
(/nodes/localhost/tasks?since=…&limit=5000), as verificações
seguintes só a janela de tarefas, e o servidor mantém a união em
SQLite (pbs_task_history, 35 dias, no máximo 10000 tarefas por
monitor) para que o calendário sobreviva a reinícios.
O que monitoriza
Seção intitulada “O que monitoriza”Todas as métricas têm o prefixo dumbmonit_pbs_.
| Família | Métricas | Etiquetas |
|---|---|---|
| Nó | node_cpu_percent, node_cpu_count, node_iowait_percent (tempo de CPU à espera de I/O — num servidor de cópias de segurança isto é o que diz que os discos estão saturados), node_load1/5/15, node_memory_used/total/free_bytes, node_memory_used_percent, node_swap_used/total_bytes, node_rootfs_used/total/avail_bytes, node_rootfs_percent, node_uptime_seconds, node_kernel_info, version_info | |
| Datastores | datastore_available, datastore_bytes_used/total/avail, datastore_used_percent, datastore_estimated_full_seconds (a própria estimativa do PBS; ausente enquanto não tem dados ou a utilização está a diminuir), datastore_dedup_factor, datastore_removable_unmounted (1 quando um datastore removível está notmounted — não é um erro, simplesmente não está ligado; etiqueta mount_status), datastore_backend_info (etiqueta backend, filesystem ou s3), datastore_maintenance (1 quando o datastore está retido para manutenção; etiqueta mode, offline, read-only…), datastore_groups e datastore_snapshots (etiqueta type, vm/ct/host/other), datastore_active_reads, datastore_active_writes (o que está a reter o datastore agora mesmo — isto explica um garbage collection que não termina), datastore_growth_percent_per_day, datastore_growth_bytes_per_day, datastore_history_days | datastore |
| Garbage collection | gc_last_removed_bytes, gc_last_pending_bytes, gc_last_run_ok (PBS 3.3+), gc_last_success_age_seconds, gc_last_duration_seconds, gc_disk_chunks, gc_last_pending_chunks, gc_last_removed_chunks, gc_bad_chunks (chunks que o GC encontrou ilegíveis e deixou no lugar — corrupção, não espaço a recuperar: uma cópia de segurança que os referencia já não pode ser restaurada), verify_last_success_age_seconds, sync_last_success_age_seconds | datastore |
| Grupos de cópia de segurança | backup_count, backup_last_timestamp_seconds, backup_last_age_seconds, backup_last_size_bytes, backup_last_verified (1 verificado, 0 falhado, ausente se nunca verificado) | datastore, namespace, backup_type, group |
| Namespaces | namespace_groups, namespace_snapshots (o namespace raiz é namespace="") | datastore, namespace |
| Tarefas na janela | tasks_running, tasks_ok, tasks_failed | worktype (backup, verificationjob, garbage_collection, prune, syncjob…) |
| Tarefas agendadas | job_enabled, job_last_ok (1 para OK ou WARNINGS: n, 0 caso contrário, ausente se a tarefa nunca correu), job_never_run (1 quando uma tarefa está ativada, tem um calendário e nunca correu — não tem nem uma falha nem um sucesso, por isso é invisível em qualquer outro lugar), job_last_run_age_seconds, job_next_run_seconds (negativo quando em atraso), sync_jobs_total, verify_jobs_total, prune_jobs_total; alias sync_job_last_ok para a regra | job, datastore, kind (sync, verify, prune); remote (remote:remote-store, ou local) em tarefas sync — o alias transporta job, datastore, remote |
Fita (opção tape, desligada por predefinição, cinco chamadas) | tape_backup_job_last_ok, tape_backup_job_never_run, tape_backup_job_last_run_age_seconds, tape_backup_job_next_run_seconds, tape_backup_jobs_total; tape_drive_info (série de presença), tape_drives_total, tape_changers_total, tape_media_pools_total; tape_media_total, tape_media_writable, tape_media_expired, tape_media_bytes_used | job, datastore, pool, drive nas tarefas; drive, vendor, model, changer em tape_drive_info; pool nas contagens de media |
| Discos (mesmos nomes que o Proxmox VE) | node_disk_size_bytes, node_disk_smart_failed (0 passed, 1 failed; ausente quando o SMART não deu veredicto), node_disk_health_info (série de presença; etiquetas health, serial, used), node_disk_wearout_percent (resistência usada, só SSD, como o PBS a mostra: 100 − wearout) | disk (/dev/sda), model, type |
| Pools ZFS (mesmos nomes que o Proxmox VE) | node_zfs_pool_degraded (0 ONLINE, 1 caso contrário), node_zfs_pool_health_info (etiqueta health), node_zfs_pool_size_bytes, node_zfs_pool_alloc_bytes, node_zfs_pool_free_bytes, node_zfs_pool_used_percent, node_zfs_pool_fragmentation_percent | pool |
| Atualizações | node_updates_pending (número de pacotes com uma atualização disponível) | |
Versões (opção updates, de /nodes/localhost/apt/versions) | node_package_upgradable (1/0), node_package_info (série de presença; etiquetas installed, available, running), node_running_version_stale (1 quando o pacote proxmox-backup-server instalado já não é o daemon em execução — o pacote foi atualizado, os serviços não foram reiniciados) | package, restrito a proxmox-backup, proxmox-backup-server, proxmox-backup-client, proxmox-kernel-helper |
Serviços (opção services, uma chamada) | node_service_active (1 em execução, 0 não), node_service_enabled (ausente para uma unidade static, que outra unidade inclui e que portanto não está nem ativada nem desativada), node_services_total | service, expected ("1" para proxmox-backup, proxmox-backup-proxy e proxmox-backup-banner, as unidades que o servidor não pode passar sem; toda outra unidade também recebe a sua série, com expected="0", e nunca gera um alerta) |
Certificado (opção certificates, desligada por predefinição) | node_certificate_expires_seconds, negativo depois de expirado | certificate (o nome do ficheiro), issuer |
Controlo de tráfego (opção traffic_control) | traffic_rate_in_bytes, traffic_rate_out_bytes (medidos no instante da verificação), traffic_limit_in_bytes, traffic_limit_out_bytes (o limite configurado, analisado das cadeias decimais do PBS como 100 MB; ausente quando essa direção não tem limite, em vez de um zero que se leria como «tudo está bloqueado»), traffic_rules_total | rule |
| Limites e coleta | backup_groups_total, backup_groups_dropped, up, scrape_errors, scrape_duration_seconds |
Uma tarefa que termina em WARNINGS: n conta como bem-sucedida. As
chamadas por datastore são limitadas a quatro em paralelo: listar
snapshots lê os índices do datastore, e uma rajada abrandaria a cópia
de segurança em curso.
As listas de tarefas não são limitadas à janela de tarefas: uma
tarefa de sync que está a falhar há três semanas continua a ser
reportada como a falhar. Uma tarefa que nunca correu não tem nenhuma
série job_last_ok, mas recebe job_never_run, e a regra «PBS job
never ran» dispara exatamente nesse caso.
O garbage collection é lido com uma única chamada /admin/gc que
cobre todo datastore de uma vez, onde antes precisava de um
/admin/datastore/{store}/gc por datastore; essa chamada por
datastore permanece como alternativa quando /admin/gc não está
disponível — um PBS mais antigo, ou um privilégio em falta — e não é
contada como um erro. /admin/gc também transporta a duração da
execução e os contadores de chunks que a chamada por datastore não
tem. gc_last_run_ok vem de last-run-state no PBS 3.3 e posterior;
em versões mais antigas recua para a tarefa de garbage collection mais
recente da janela. As contagens por tipo vêm de
/admin/datastore/{store}/status?verbose=1: sem verbose, o PBS só
devolve os tamanhos, que /status/datastore-usage já dava.
/admin/datastore/{store}/namespace devolve toda a árvore de
namespace, por isso nada se perde em sub-namespaces —
pve/site-a/rack1 é contado como a raiz. Os discos e pools vêm de
/nodes/localhost/disks/list e /nodes/localhost/disks/zfs (opção
disks; um 403 é tolerado, e também o é o 400 que um servidor sem
ZFS responde: nenhuma série de pool, nenhum erro de coleta).
datastore_growth_percent_per_day é um ajuste de mínimos quadrados
sobre o histórico de utilização que o próprio PBS devolve com
/status/datastore-usage: uma fração de utilização entre 0 e 1, um
ponto a cada trinta minutos no último mês, com buracos null que são
ignorados em vez de preenchidos — um servidor que estava desligado não
cresceu enquanto estava desligado. Estes são os mesmos números por
detrás da própria previsão «full in N days» do PBS. São precisos pelo
menos oito pontos medidos antes de algo ser publicado, e
datastore_history_days diz quanto histórico a inclinação cobre. Um
valor negativo não é uma falha: o prune está a recuperar mais do que
as cópias de segurança adicionam.
Nada de todo é publicado para fita quando o servidor não tem drive, changer, pool nem tarefa de fita — uma instalação sem fita não deve ganhar uma dúzia de séries a zero que se lêem como um nível de fita em dificuldades. Uma fita que não pertence a nenhuma pool, media em branco ou media retirada de uma pool, não entra em nenhuma contagem de pool.
Dispositivos
Seção intitulada “Dispositivos”Toda máquina com cópia de segurança — anfitrião, VM ou contentor — é
também publicada sob a família genérica partilhada por toda
integração do DumbMonit que acompanha dispositivos protegidos —
dumbmonit_client_device_*, prefixada sem pbs, documentada na
íntegra em Dispositivos cliente.
Nada de novo é pedido ao PBS: é a mesma data de último snapshot já
por detrás de backup_last_timestamp_seconds, republicada sob a
família partilhada para que uma regra e uma tabela sirvam o PBS junto
com toda outra integração que protege um dispositivo.
| Métrica | O quê | Etiquetas |
|---|---|---|
last_backup_timestamp_seconds | O mesmo instante que backup_last_timestamp_seconds para esse grupo | device, type, os, user, kind |
stale_seconds | Positivo uma vez que um grupo passou device_stale_days (3 por predefinição) sem um novo snapshot; alimenta a regra Dispositivo obsoleto | device, type, os, user, kind, signal (sempre backup) |
Limite a conhecer: o PBS não regista uma «ligação» separada para
uma máquina com cópia de segurança, só cópias de segurança —
last_seen_timestamp_seconds e o sinal connection nunca são
publicados aqui; um dispositivo mostra last_connection como «—» na
tabela da página do dispositivo. O dispositivo nomeado no alerta é o
nome do convidado das notas do snapshot quando o PVE escreveu uma,
caso contrário type/id, o mesmo que o calendário de cópias de
segurança.
As regras incorporadas que se aplicam: Monitor unreachable, PBS datastore almost full, PBS datastore filling up, PBS backup too old (por grupo de cópia de segurança: nenhum snapshot novo há dois dias — edite o limiar da regra para uma janela mais longa), PBS backup verification failed, PBS task failed, PBS garbage collection too old, PBS garbage collection failed, PBS corrupt chunks found, PBS sync job failed, PBS prune job failed, PBS verification job failed, PBS job never ran, PBS datastore not mounted, PBS service down, PBS restart pending after upgrade, PBS certificate expiring, PBS tape backup failed, PBS disk SMART failure, PBS SSD worn out, PBS ZFS pool degraded, PBS updates pending, Client device stale. As notificações nomeiam a tarefa, datastore ou grupo de cópia de segurança em causa.
O que preparar no PBS
Seção intitulada “O que preparar no PBS”Os passos abaixo são os que o aviso junto ao formulário mostra. O princípio: um utilizador reservado para monitorização, um token com uma função só de leitura — nunca a conta com que inicia sessão.
-
Abra uma shell no servidor de cópias de segurança (na interface web: Administration → Shell; ou SSH) e crie um utilizador reservado para monitorização. Não precisa de senha: o token é que inicia sessão.
proxmox-backup-manager user create dumbmonit@pbs --comment "DumbMonit monitoring" -
Crie o token de API do utilizador. O comando imprime o id do token e o seu segredo: copie ambos agora, o PBS nunca mostra o segredo de novo.
proxmox-backup-manager user generate-token dumbmonit@pbs monitor -
Dê o mínimo só de leitura, por caminho — ao token e ao utilizador que o detém. Os privilégios efetivos de um token são a intersecção da sua própria ACL e da do seu utilizador: concedidos só ao token, não equivalem a nada, e o PBS não reporta isso em lado nenhum. Cada linha é portanto escrita duas vezes.
DatastoreAuditem/datastore(Datastore.Audit) lê os datastores, snapshots, tarefas de verify e prune e GC;Auditem/system(Sys.Audit) lê o estado do nó, a lista de tarefas e registos de tarefa, os serviços, as regras de controlo de tráfego, os discos e pools ZFS.proxmox-backup-manager acl update /datastore DatastoreAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /datastore DatastoreAudit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update /system Audit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /system Audit --auth-id 'dumbmonit@pbs!monitor'Opcional, e também duas vezes.
RemoteAuditem/remote(Remote.Audit) mostra as tarefas de sync que obtêm de um remoto: a função incorporadaAuditsó cobreSys.AuditeDatastore.Audit, e semRemote.Audittal tarefa não é recusada, simplesmente está ausente da lista de tarefas.TapeAuditem/tape(Tape.Audit) lê o nível de fita.Auditem/(Sys.Auditao nível raiz) lista as atualizações de pacote pendentes, e também cobre/datastoree/systemse preferir menos linhas. Sem eles esses itens são ignorados silenciosamente, nada mais muda. Nada aqui pode escrever: o coletor só executaGETs.proxmox-backup-manager acl update /remote RemoteAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /remote RemoteAudit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update /tape TapeAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /tape TapeAudit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update / Audit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update / Audit --auth-id 'dumbmonit@pbs!monitor' -
Antes de sair da shell, verifique o que o token realmente pode ler. O comando imprime os seus privilégios efetivos, caminho a caminho; um resultado vazio significa que o utilizador não tem a ACL que o token tem — o caso em que o monitor parece perfeitamente vivo e não reporta nada.
proxmox-backup-manager user permissions 'dumbmonit@pbs!monitor' -
Copie o id do token para o campo Token ID do DumbMonit e o segredo para o seu campo Secret.
dumbmonit@pbs!monitor -
Prefere a interface web? Configuration → Access Control: Users → Add, depois API Tokens → Add, depois Permissions → Add. Adicione cada permissão duas vezes, uma como User Permission para
dumbmonit@pbse uma como API Token Permission paradumbmonit@pbs!monitor: com caminho/datastoree funçãoDatastoreAudit, depois de novo com caminho/systeme funçãoAudit. Uma permissão de token por si só não concede nada. -
No DumbMonit, introduza o endereço do servidor, por exemplo «pbs.lan» ou «pbs.lan:8007».
Documentação do fornecedor: PBS API tokens.
Credenciais
Seção intitulada “Credenciais”| Credencial | Campos |
|---|---|
| Token de API (recomendado) | Token ID: utilizador, realm e nome do token como o PBS os mostra, dumbmonit@pbs!monitor. Secret: o UUID mostrado uma vez quando o token foi criado. O DumbMonit envia-os como o cabeçalho PBSAPIToken=user@pbs!name:secret que o PBS espera. |
| Nome de utilizador / senha | user@pbs (ou @pam) e a senha. Um bilhete é obtido, posto em cache e renovado dez minutos antes da sua expiração de duas horas. |
A API aceita o token em duas partes (token_id + secret) ou, como
versões mais antigas faziam, como uma única cadeia token =
user@pbs!name=secret; ambas são guardadas da mesma forma. Um token
completo colado em Token ID é dividido pelo formulário.
Direitos, só de leitura, e concedidos duas vezes: os privilégios
efetivos de um token são a intersecção da sua própria ACL e da do seu
utilizador, por isso cada função abaixo tem de ser dada a
dumbmonit@pbs tal como a dumbmonit@pbs!monitor. Mais simples: a
função incorporada Audit em /, mais RemoteAudit em /remote
para tarefas de sync e TapeAudit em /tape para o nível de fita —
Audit só cobre Sys.Audit e Datastore.Audit, e essas duas funções
existem precisamente porque não cobre. Por endpoint:
| Endpoint | Precisa de |
|---|---|
GET /version | qualquer utilizador autenticado |
GET /nodes/localhost/status, GET /nodes/localhost/tasks, GET /nodes/localhost/tasks/{upid}/log | Sys.Audit em /system (Audit em /system) |
GET /nodes/localhost/disks/list, …/disks/smart, …/disks/zfs | Sys.Audit em /system (Audit em /system); um 403 é tolerado: nenhuma série de disco, nenhum erro de coleta. …/disks/zfs responde 400 num servidor sem ZFS, tolerado da mesma forma |
GET /nodes/localhost/services, GET /admin/traffic-control | Sys.Audit em /system (Audit em /system); um 403 é tolerado: nenhuma série, nenhum erro de coleta |
GET /nodes/localhost/certificates/info | Sys.Modify em /system — um privilégio de escrita, por isso a opção certificates está desligada por predefinição e um token de monitorização não é esperado tê-lo |
GET /status/datastore-usage, GET /admin/gc, GET /config/datastore, GET /admin/datastore/{store}/gc, …/status, …/active-operations, …/namespace, …/snapshots | Datastore.Audit em /datastore/{store} (DatastoreAudit em /datastore) |
GET /admin/verify, GET /admin/prune | listadas para os datastores onde o token tem Datastore.Audit; outras tarefas são omitidas silenciosamente |
GET /admin/sync | Datastore.Audit no datastore e Remote.Audit em /remote/{remote} (RemoteAudit em /remote); outras tarefas são omitidas silenciosamente |
GET /nodes/localhost/apt/update, …/apt/versions | Sys.Audit em / (Audit em /); um 403 é tolerado: nenhuma série de atualização ou versão, nenhum erro de coleta |
GET /tape/backup, /tape/drive, /tape/changer, /config/media-pool, /tape/media/list | Tape.Audit em /tape (TapeAudit em /tape); toda falha é tolerada, um PBS sem suporte de fita incluído: nenhuma série de fita, nenhum erro de coleta |
Note que Audit em /system por si só não cobre a lista de
atualizações, que o PBS verifica no caminho raiz. Um 403 nas listas
de tarefas ou na lista de atualizações é tratado como um privilégio
opcional: nada é produzido e nada é contado em scrape_errors. E uma
função em falta no utilizador é pior do que um 403: a chamada tem
sucesso e devolve uma lista vazia, por isso nada é produzido e nada se
queixa também.
Endereço: 10.0.0.20, pbs.lan, pbs.lan:8007, [fd00::2] ou um URL
completo. O esquema https e a porta 8007 são adicionados se
estiverem em falta.
| Chave | Rótulo | Predefinição | Ajuda |
|---|---|---|---|
port | API port | 8007 | Usada se o endereço não der uma porta. |
insecure_tls | Accept an unverifiable certificate | false | O Proxmox Backup Server vem com um certificado autoassinado por predefinição: ative isto se a ligação for recusada por esse motivo. |
request_timeout_seconds | Timeout per request (seconds) | 15 | Tempo permitido para cada chamada de API, de 1 a 120. Listar os snapshots de um datastore grande pode demorar vários segundos. |
task_lookback_hours | Task window (hours) | 24 | Tarefas mais antigas não são contadas entre as falhas, de 1 a 8760. |
datastores | Monitored datastores | (vazio) | Nomes dos datastores a monitorizar, separados por vírgulas. Vazio: todo datastore. |
max_groups | Backup group limit | 500 | Número máximo de máquinas com cópia de segurança a produzir série; além disso, as mais antigas são ignoradas. De 1 a 100000. |
jobs | Watch scheduled jobs | true | Lista as tarefas de sync, verify e prune e a sua última execução (/admin/sync, /admin/verify, /admin/prune). |
updates | Watch pending updates | true | Conta os pacotes com uma atualização disponível (/nodes/localhost/apt/update). |
disks | Watch disks and ZFS pools | true | Lê os discos físicos (veredicto SMART, desgaste de SSD) e os pools ZFS (/nodes/localhost/disks). |
services | Watch the server’s services | true | Lê as unidades systemd e reporta se as que o servidor não pode passar sem estão em execução. Precisa de Sys.Audit em /system; ignorado silenciosamente caso contrário. |
datastore_details | Read datastore detail | true | Mais duas chamadas por datastore: quantas máquinas e snapshots contém, o que o está a ler ou escrever agora mesmo, e se está retido para manutenção. |
traffic_control | Watch traffic limits | true | Lê os limites de taxa e o que estão a transportar agora mesmo. Precisa de Sys.Audit; ignorado silenciosamente caso contrário. |
certificates | Watch certificate expiry | false | Desligada por predefinição: o PBS protege esta chamada com Sys.Modify, um privilégio de escrita que um token de monitorização não deveria ter. |
tape | Watch tape backups | false | Lê o nível de fita. Desligada por predefinição, já que a maioria das instalações não tem hardware de fita. Precisa de Tape.Audit em /tape. |
device_stale_days | Device staleness (days) | 3 | Uma máquina com cópia de segurança sem nenhum snapshot novo há mais tempo do que isto é reportada como obsoleta. De 1 a 90. |
Erros comuns
Seção intitulada “Erros comuns”| Sintoma | Causa provável |
|---|---|
| Erro de certificado | Certificado autoassinado: instale um de confiança (ACME está incorporado no PBS) ou ative insecure_tls. |
| Erro de autenticação | O segredo colado em Token ID (ou o inverso), ou o token não tem nenhuma permissão Audit — mais frequentemente porque a função foi concedida ao token mas não ao utilizador que o detém, o que não falha: as chamadas têm sucesso e devolvem listas vazias. Só a falha de GET /version condena toda a verificação; qualquer outra chamada falhada é contada em scrape_errors. |
| Tudo lê vazio mas o monitor está ativo | O utilizador não tem a ACL que o token tem, e o PBS intersecta os dois: proxmox-backup-manager user permissions 'dumbmonit@pbs!monitor' não imprime nada. Conceda toda função a dumbmonit@pbs também. |
Nenhuma série node_updates_pending | O token não tem Sys.Audit em /: dê-lhe a função Audit em /, ou defina updates para false para parar de perguntar. |
| Uma tarefa de sync está em falta | O token não tem Remote.Audit no remoto da tarefa: adicione a função RemoteAudit em /remote. A tarefa não é recusada, simplesmente está ausente da lista. |
| Nenhuma expiração de certificado | A opção certificates está desligada, o que é a predefinição: o PBS exige Sys.Modify para essa chamada, um privilégio de escrita. |
| O painel Tape nunca aparece | A opção tape está desligada, o que é a predefinição, ou o servidor não tem drive, changer, pool ou tarefa de fita. Nada é publicado quando não há nada. |
| Nenhum valor de crescimento num datastore | O histórico de utilização do PBS tem menos de oito pontos medidos; preenche-se nos primeiros dias. |
| «PBS datastore filling up» nunca dispara | datastore_estimated_full_seconds é calculado pelo PBS a partir de um mês de medições e fica ausente até então. |
| Grupos em falta | Mais de max_groups máquinas com cópia de segurança: backup_groups_dropped diz quantas foram deixadas de fora. |
| O calendário está vazio ou curto | Preenche-se a partir da lista de tarefas na primeira verificação depois de um arranque (últimos 30 dias); um PBS cujo arquivo de tarefas foi limpo só mostra o que resta. Uma máquina que nunca teve cópia de segurança para este servidor e nunca teve uma tarefa não tem nenhuma linha. |
Uma máquina mostra-se como vm/104 sem o seu nome | O PVE só escreve o nome do convidado nas notas do snapshot com o modelo de notas predefinido ({{guestname}}); um modelo personalizado ou um PVE mais antigo deixa as notas vazias. |
| «Show log» falha | O token não tem Sys.Audit em /system para o registo da tarefa, ou o PBS já rotacionou o registo de uma tarefa antiga. |